 Gao Kaptan Docs
vLLM (OpenAI API)
 vLLM (OpenAI API)
MIG üzerinde vLLM ile OpenAI-uyumlu bir LLM sunucusu çalıştır ve relay üzerinden istek at.
vLLM, yüksek verimli, OpenAI-uyumlu bir LLM çıkarım sunucusudur. Bir MIG dilimi üzerinde çalıştırıp relay üzerinden dışarıdan, mevcut OpenAI istemcilerinizle kullanabilirsiniz.
vLLM'i MIG ile dağıt
Katalog → vLLM (OpenAI API, 1× MIG) → Deploy. Model, MIG diliminize sığmalıdır —
1g.18gb (18 GB) için küçük/kuantize bir model seçin (ör. Qwen/Qwen2.5-0.5B-Instruct veya
şablonun varsayılanı Qwen2.5-7B-Instruct-AWQ). Port 8000, dış erişim (relay) + internet açık.
args içindeki --model değerini MIG boyutuna göre ayarlayın; --gpu-memory-utilization ve
--max-model-len ile belleğe sığdırın. Model ilk açılışta indirilir (internet erişimi gerekir).
Erişim token'ı al
Pod detayından bir API token oluşturun; relay isteklerinde bu token'ı kullanacaksınız.
curl -s -X POST https://kaptan.isnet.net.tr/api/v1/pods/<POD_ID>/access-token/regenerate \
  -H "Authorization: Bearer <JWT>"
# -> { "data": { "api_token": "<API_TOKEN>" } }
Relay üzerinden modele istek at
kptnpods.isnet.net.tr relay'ini <subdomain> (pod ingress host'unun ilk etiketi) ve
<API_TOKEN> ile kullanın. Uçlar OpenAI-uyumludur (/v1/models, /v1/chat/completions):
BASE="https://kptnpods.isnet.net.tr/v1"
Q="kaptan_subdomain=<subdomain>&kaptan_token=<API_TOKEN>"

# modelleri listele
curl -s "$BASE/models?$Q"

# sohbet tamamlama
curl -s -X POST "$BASE/chat/completions?$Q" \
  -H "Content-Type: application/json" \
  -d '{"model":"Qwen/Qwen2.5-0.5B-Instruct",
       "messages":[{"role":"user","content":"What is a GPU? One sentence."}],
       "max_tokens":40}'
Yanıt (relay, HTTP 200) — standart OpenAI şeması:
{ "choices": [{ "message": { "role": "assistant",
   "content": "A GPU (Graphics Processing Unit) is a specialized chip designed to accelerate..." }}],
  "usage": { "prompt_tokens": 37, "completion_tokens": 36, "total_tokens": 73 } }
(Opsiyonel) Pod içinden hızlı doğrulama
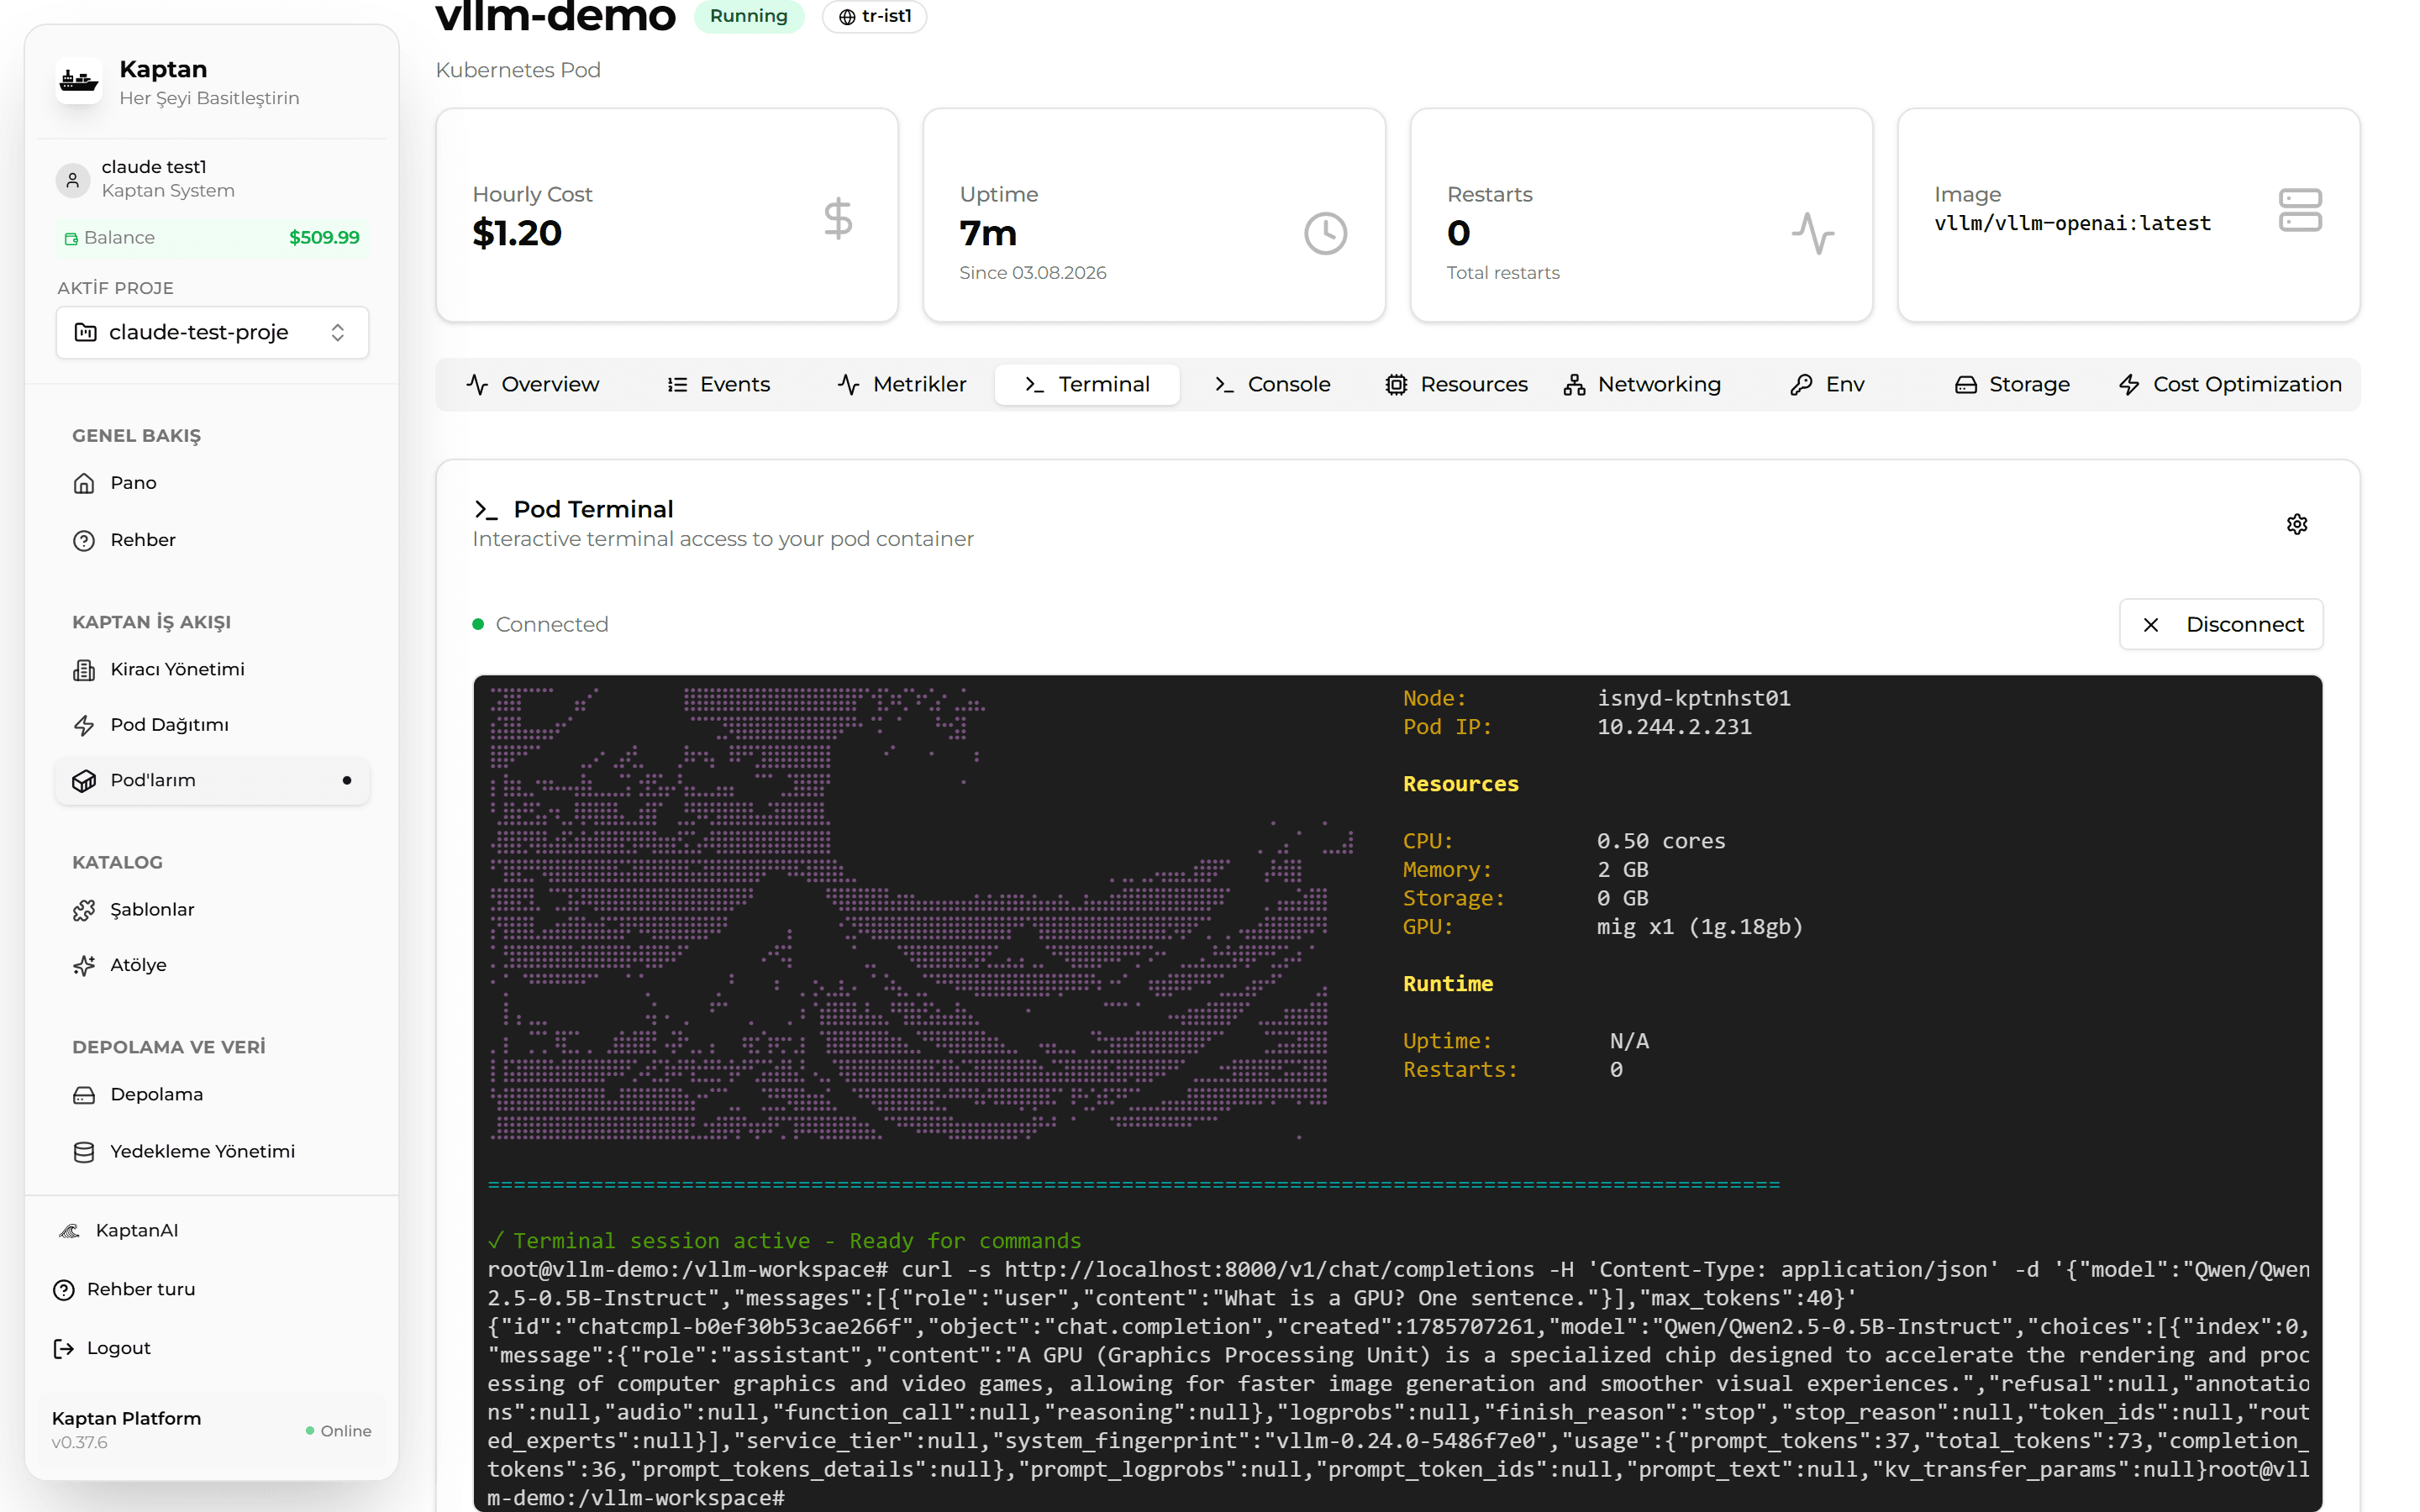
Sunucunun ayakta olduğunu pod Terminal'inden de görebilirsiniz: