 Gao Kaptan Docs
Pi: kendi modelinizle çalışan terminal ajanı
Pi coding agent'ı Kaptan'a kurun ve Kaptan inference'taki Qwen'e köprüsüz bağlayın. İki JSON dosyası, tek npm paketi.
Pi, Earendil Works'ün açık kaynak terminal kodlama ajanıdır: dosyalarınızı okur, kod yazar, komut çalıştırır ve sonucuna göre kendini düzeltir. Kendi ajan döngüsünü getirir — Claude Code, Codex ya da başka bir ajan gerekmez, ikisi aynı işi yapan rakiplerdir.
Gao Kaptan açısından asıl değeri şu: Pi'nin LLM katmanı çok sağlayıcılıdır ve OpenAI-uyumlu bir uç noktayı doğrudan konuşur. Gao Kaptan inference da OpenAI-uyumlu olduğu için araya hiçbir şey girmez.
Claude Code ile fark burada. Claude Code Anthropic biçimini (/v1/messages) konuşur;
Gao Kaptan inference'a bağlamak için bir LiteLLM köprüsü kurup modeli tanıdığı bir adla
maskelemek gerekir (o örnek). Pi'de bunların
hiçbiri yok: iki JSON dosyası yeterli.
Kurulum
Pod
Sıradan bir ubuntu:24.04 pod'u yeter — GPU gerekmez, model uzakta çalışıyor. 4 vCPU,
8 GB RAM, 25 GB disk rahat. İnternet çıkışını açın (npm ve inference için).
Node 24 + Pi
apt-get update && apt-get install -y curl ca-certificates git python3
curl -fsSL https://deb.nodesource.com/setup_24.x | bash -
apt-get install -y nodejs

npm install -g --ignore-scripts @earendil-works/pi-coding-agent
pi --version
--ignore-scripts Pi'nin kendi önerisi: normal kurulumda yaşam döngüsü betiklerine ihtiyaç
duymuyor.
Gao Kaptan inference'ı sağlayıcı olarak tanıtın
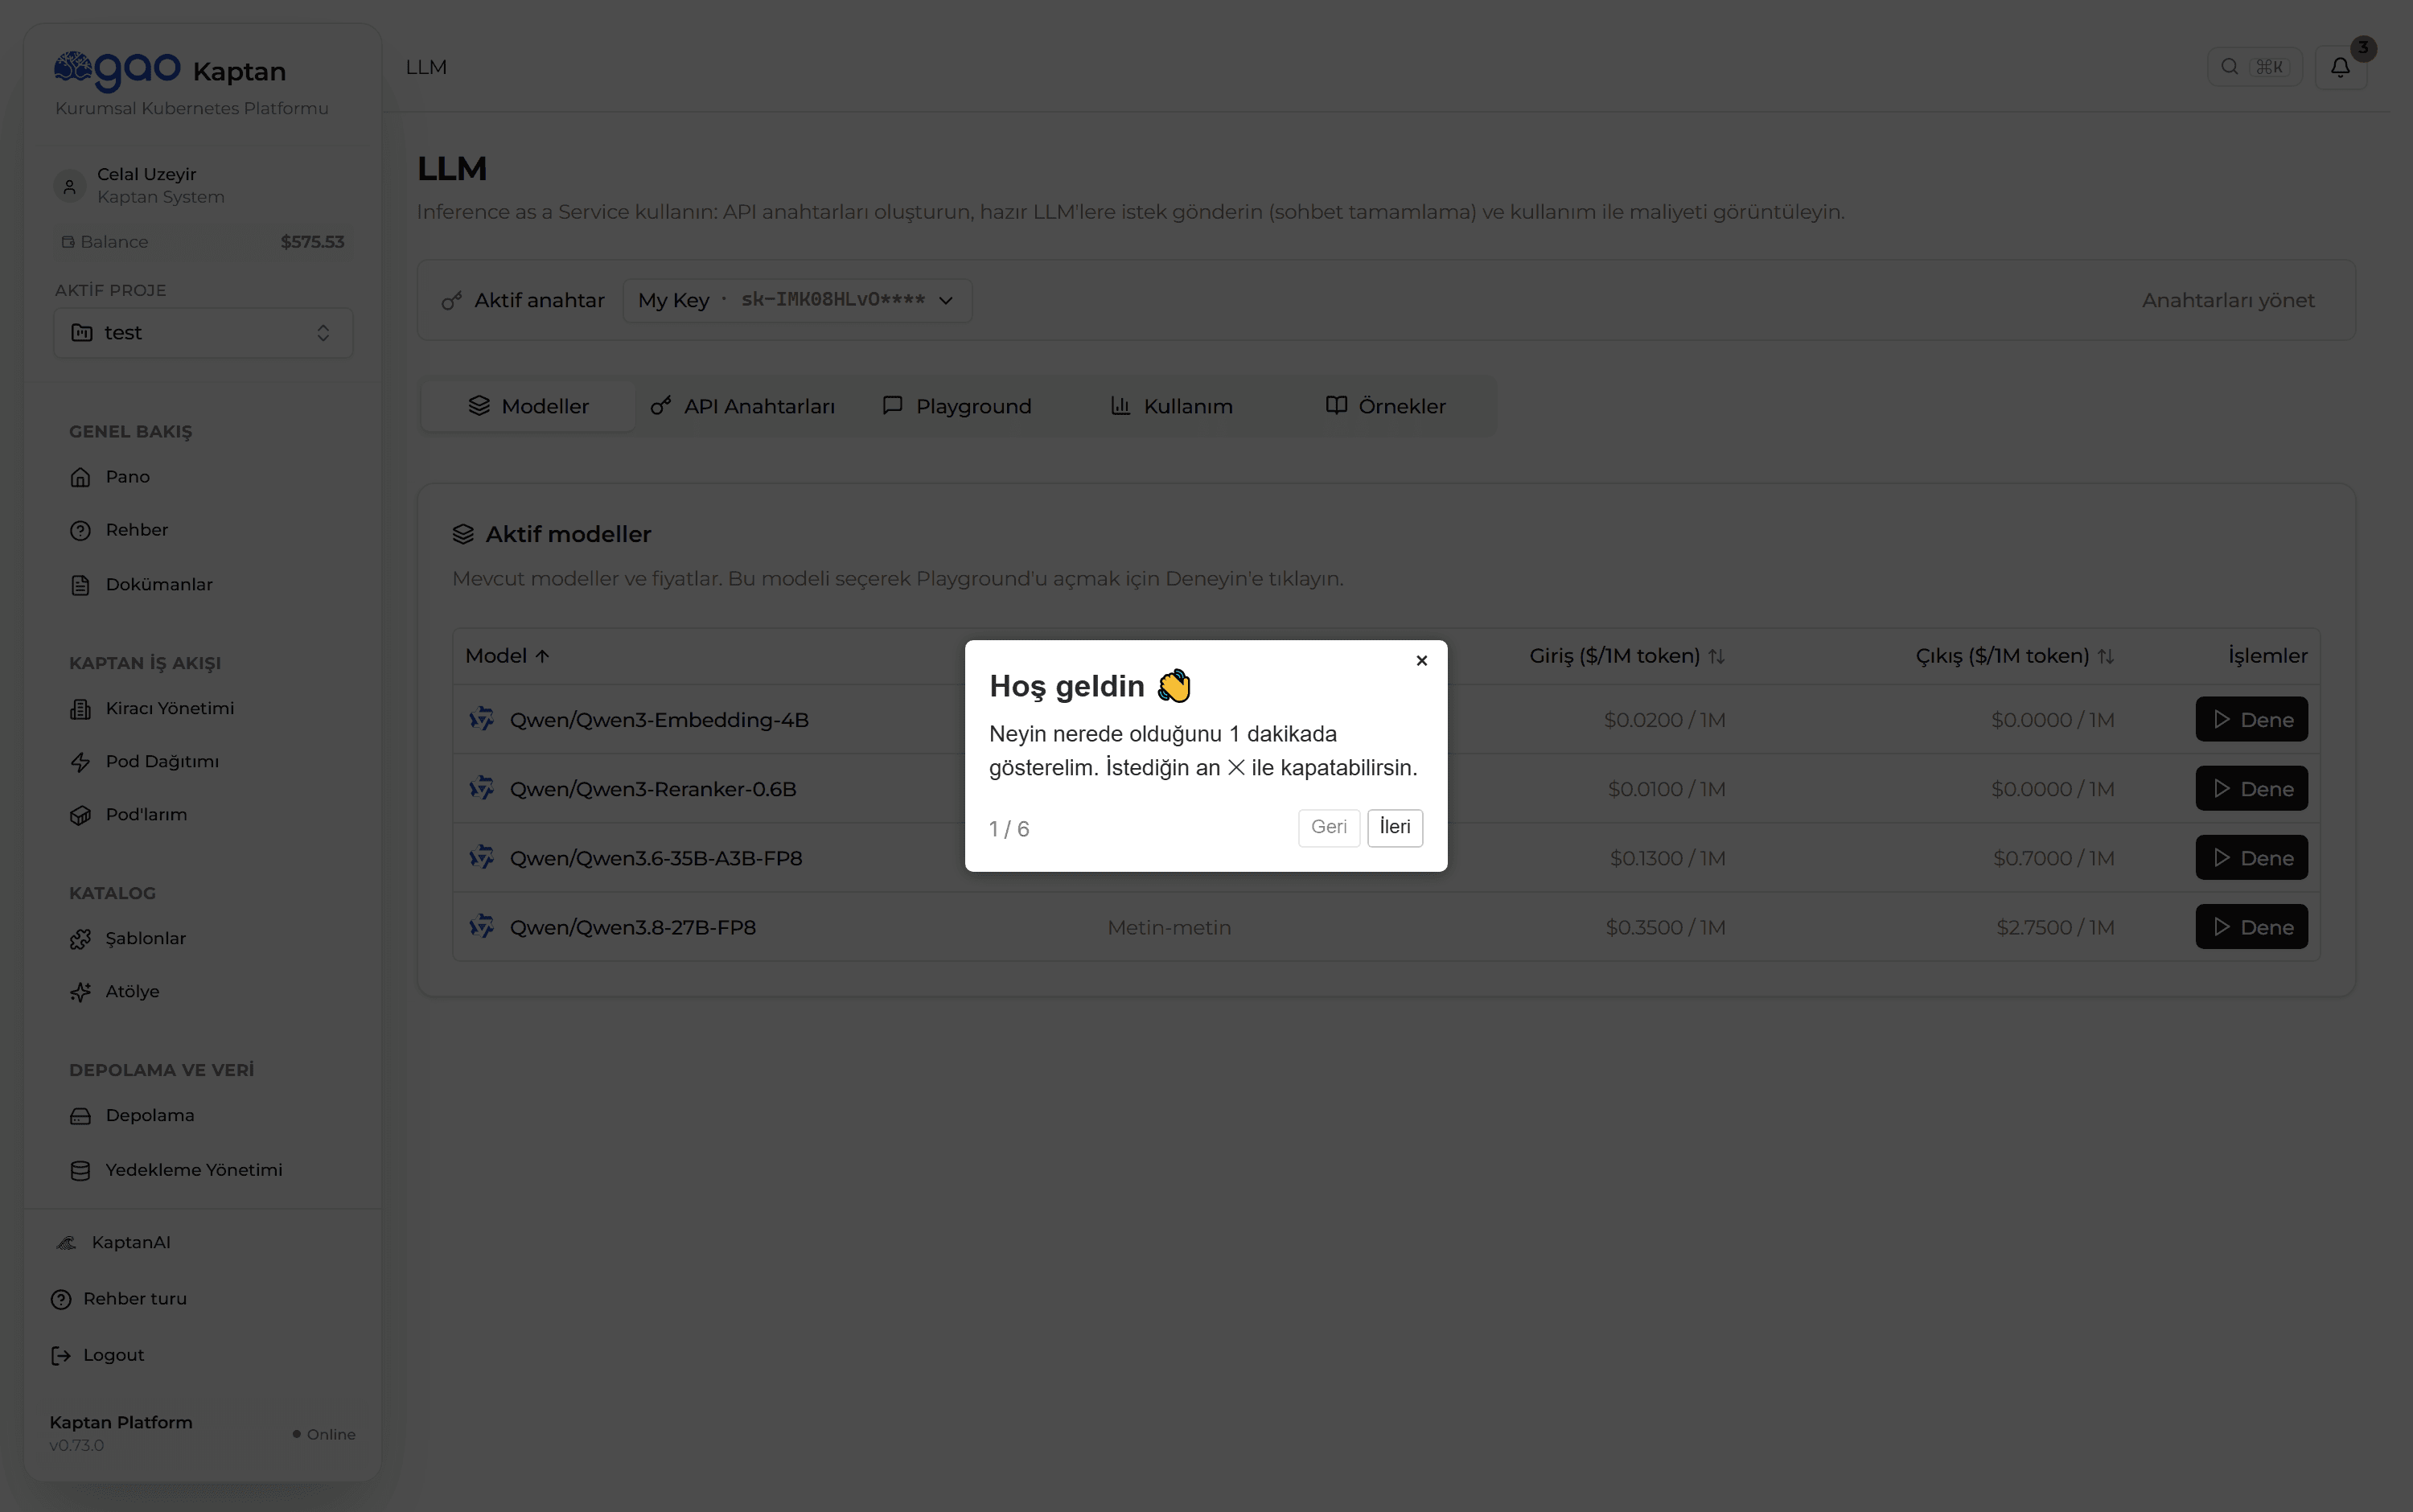
Gao Kaptan panelinde LLM sayfasından bir API anahtarı üretin. Aynı sayfada aktif modelleri ve fiyatlarını görürsünüz:
Sonra $HOME/.pi/agent/models.json:
{
  "providers": {
    "kaptan": {
      "baseUrl": "https://kaptan.isnet.net.tr/api/v1/inference/v1",
      "api": "openai-completions",
      "apiKey": "sk-…",
      "compat": {
        "supportsDeveloperRole": false,
        "supportsReasoningEffort": false
      },
      "models": [
        { "id": "Qwen/Qwen3.8-27B-FP8" },
        { "id": "Qwen/Qwen3.6-35B-A3B-FP8" }
      ]
    }
  }
}
Dosya $HOME altında olmalı. Gao Kaptan pod'larında HOME=/home/kaptan'dır, /root değil —
konteyner root olarak çalışsa bile. Yanlış yere yazarsanız Pi hiçbir şey söylemeden
"No models available" der.
compat iki bayrağı da gerekir. developer rolü ve reasoning_effort, OpenAI'nin yeni
akıl-yürütme sözleşmesine aittir; vLLM tabanlı sunucularda karşılığı yoktur. Kapatmazsanız
istekler reddedilir.
Doğrulama:
pi --list-modelsprovider model context max-out thinking images
kaptan Qwen/Qwen3.8-27B-FP8 128K 16.4K no no
kaptan Qwen/Qwen3.6-35B-A3B-FP8 128K 16.4K no noVarsayılan modeli sabitleyin
$HOME/.pi/agent/settings.json:
{ "defaultModel": "kaptan/Qwen/Qwen3.8-27B-FP8" }Model kimliği sağlayıcı/model biçimindedir. Bundan sonra pi yazmanız yeterli; --model
bayrağına gerek kalmaz. (Etkileşimli oturumda /model ya da Ctrl+L ile de seçip Ctrl+S
ile kaydedebilirsiniz.)
Kullanım
Etkileşimli oturum için pi, tek seferlik iş için -p:
cd /workspace/projem
pi -p "asal.py dosyasını oku. Algoritması her sayı için bölme deniyor; bunu
       Eratosthenes kalburuna çevir, aynı çıktıyı versin. Sonra betiği çalıştır."
Ajanın gerçekten yaptığı iş — okudu, değiştirdi, çalıştırdı, doğruladı:
İlk 5 asal sayı: 2, 3, 5, 7, 11
Son 5 asal sayı: 71, 73, 79, 89, 97

| Özellik    | Eski (Trial Division)      | Yeni (Eratosthenes Kalburu)    |
| Yaklaşım   | Her sayı için bölme        | Tek seferde filtreleme         |
| Verimlilik | O(n √n)                    | O(n log log n)                 |
Dosyanın kendisi de gerçekten yeniden yazılmıştı (i*i'den başlayan iç döngü dahil) ve
hatasız koştu.
Ölçüm: Pi ve Claude Code, aynı model üzerinde
Adil karşılaştırma için tek değişken ajan olmalı. İkisi de aynı pod'da, aynı
LiteLLM köprüsü üzerinden aynı Qwen3.8-27B-FP8'e bağlandı. Üç görev, iki tur,
her koşu sıfırdan temiz bir kopyada. Hakem, ajanların görmediği gizli testlerdi
(pod'da bulunmuyorlardı, sonuçlar dışarıda koşuldu).
Ölçüm tekrarlanabilir olsun diye tam sürümler:
| Bileşen | Sürüm |
|---|---|
| Pi | @earendil-works/pi-coding-agent 0.85.1 |
| Claude Code | 2.1.261 (@anthropic-ai/claude-code-linux-x64) |
| Model (ikisi de) | Qwen/Qwen3.8-27B-FP8 — vLLM 0.26.1rc1 |
| Köprü | LiteLLM 1.99.0 (yalnız Claude Code için gerekli) |
| Çalışma ortamı | ubuntu:24.04, Node 24.20.0, Python 3.12.3, 32 vCPU / 31 GB RAM |
| Ponytail | 4.9.0 (aşağıdaki skill bölümünde) |
Görevler
Üçü de gerçek bir kusur içeriyor ve hepsinin tek doğru cevabı var; hiçbiri "güzel kod yaz" gibi öznel değil. Ajanlar testleri hiç görmedi — test dosyaları pod'a kopyalanmadı, sonuçlar dışarı çekilip orada koşuldu.
| Ne | Tuzağı | Hakem | |
|---|---|---|---|
| A | Tek dosyada KDV + kademeli indirim hesabı. İki hata: eşik > olmalıyken >= ve indirim kademesi KDV hariç matrah yerine KDV dahil ara toplamdan seçiliyor. | İkinci hata yalnızca belirli tutarlarda görünüyor; şartname okunmadan bulunamaz. | 4 birim test |
| B | Dört dosyalı iş kuyruğu. Kuyruk "en az bir kez" teslim ediyor, tekilleştirme depoda yapılıyor ve check-then-act kilitsiz — işler iki kez işleniyor. | Kodda yanıltıcı bir yorum var (GIL sayesinde atomik, kilide gerek yok) ve README hatayı başka bir dosyaya işaret ediyor. | 5 test, 8 ve 16 işçiyle |
| C | Beş dosyalı servis. "KPT_DB_POOL=5 koyduk, hiçbir şey değişmedi" — kaç bağlantı açılıyor ve neden? Kod değiştirmek yasak, yalnızca teşhis. | Ortam değişkeni adı alan adından türetiliyor, yani KPT_DB_POOL dizesi kodda hiç geçmiyor — grep ile bulunamaz. Üstüne taşma payı ve prefork'ta süreç başına havuz çarpanı biniyor. | Doğru cevap 300; dört kriter tek tek puanlandı |
C görevi kasıtlı olarak bu depoda gerçekten yaşanmış bir olaydan türetildi (Celery prefork'ta çocuk başına havuz açılması). "Derin" olmasının sebebi uzunluğu değil, cevabın üç ayrı katmanın çarpımı olması.
| Görev | Süre | LLM çağrısı | Girdi token | Gizli test | |
|---|---|---|---|---|---|
| A — tek dosyada iş kuralı hatası | Pi | 12s / 8s | 7 / 4 | 16K / 9K | 4/4 · 4/4 |
| Claude Code | 23s / 22s | 8 / 8 | 210K / 214K | 4/4 · 4/4 | |
| B — çok dosyalı yarış durumu | Pi | 12s / 8s | 7 / 6 | 21K / 17K | 5/5 · 5/5 |
| Claude Code | 18s / 18s | 8 / 8 | 212K / 211K | 5/5 · 5/5 | |
| C — derin teşhis (kod yazmadan) | Pi | 12s / 9s | 4 / 4 | 9K / 9K | kısmi · kısmi |
| Claude Code | 252s / 958s | 5 / 5 | 123K / 127K | kısmi · düştü |
Toplam: Pi 61 saniye / 82K girdi token, Claude Code 1291 saniye / 1.096K girdi token — yani 13× token, 21× süre.
Ne ayırt etti, ne etmedi
Kod düzeltme görevlerinde fark yok. A ve B'de dört koşunun dördü de testleri tam
geçti. B'de kod, kök nedenin bulunduğu yerde yanıltıcı bir yorum taşıyordu
(# dict okuma/yazma GIL sayesinde atomik oldugu icin burada kilide gerek yok) ve
README hatayı başka bir dosyaya işaret ediyordu; ikisi de tuzağa düşmedi, doğru
katmanı buldu ve düzeltmeyi beşer kez doğruladı.
Fark, girdi yükünde ve kararlılıkta. Claude Code her turda ~26K token'lık bir
sistem promptu + araç şeması taşıyor; bu kendi modeli için tasarlanmış bir bütçe.
128K bağlamlı bir modelde aynı yükü her turda taşımak hem pahalı hem kırılgan:
C görevinin ikinci turunda Claude Code 16 dakika koştu, max_tokens=16000 tavanına
dört kez dayandı ve hiçbir çıktı üretmeden düştü. Pi aynı görevi 9 saniyede,
9K token ile bitirdi.
Modelin sınırı, ajanın sınırı değil. C görevinde doğru cevap 300 bağlantıydı; ikisi de üç kök nedeni de doğru buldu (ortam değişkeni adının alan adından türetilmesi, taşma payı, prefork'ta süreç başına havuz) ama ikisi de toplamı yanlış hesapladı — Pi 120/152, Claude Code 360. Ajanı değiştirmek bunu düzeltmez; model değiştirmek düzeltir.
Bu ölçüm Claude Code'u kendi modeli olmadan değerlendiriyor. Sonuç şu soruyu yanıtlar: kurum içi Qwen'e bağlandığında hangisi daha iyi çalışıyor? Claude Code'un Sonnet ile davranışı hakkında hiçbir şey söylemez.
Çıktı tavanını yükseltmek Claude Code'u kurtarmadı
C görevi ilk turda max_tokens=16000 ile koşulmuştu ve Claude Code o tavana dayanıp
düşmüştü. Tavanın suçlu olup olmadığını görmek için tek değişkeni tavan yapıp
120.000'e çıkarıp aynı görev tekrar koşuldu:
| 16K tavan | 120K tavan | |
|---|---|---|
| Pi | 12s · 9K girdi · cevap 120 (yanlış) | 14s · 15K girdi · cevap 300 (doğru) |
| Claude Code | 958s · dört kez tavana dayandı · düştü | 1200s · tek çağrıda 64K token · timeout |
Pi düzeldi, Claude Code kötüleşti. Tavan yükselince Pi düşünmesini tamamlayıp doğru
cevabı verdi. Claude Code ise tek bir istekte 978 saniye boyunca 64.000 token üretti,
yine tamamlayamadı ve 20 dakikalık zaman aşımıyla öldü (exit 124, hiç çıktı yok).
Bu bir model sınırı değil, ajan–model uyumsuzluğu: Claude Code'un araç çağrısı sözleşmesi kendi modeli için tasarlanmış; Qwen o sözleşmeyi kapatamayınca durma koşulu tetiklenmiyor ve ajan tavana kadar üretiyor. Tavanı yükseltmek yalnızca faturayı büyütür. Kendi modelinizle çalışacaksanız bu tek başına belirleyici bir bulgudur.
Skill eklemek: Pi'de de var, aynı paket
Pi'nin kendi paket kayıt defteri var (packages.pi.dev, 5.300'ü aşkın paket) ve Skills onun birincil genişletme mekanizması. Yani "skill'ler Claude Code'a özgü" değil — popüler skill'lerin çoğu iki tarafta da kurulabiliyor.
Ponytail ile denendi (gereğinden fazla kod yazmayı engellemeyi amaçlayan bir kural seti). Kurulum, iki tarafta da tek seferlik:
# Pi — tek komut
pi install git:github.com/DietrichGebert/ponytail

# Claude Code — iki ayrı komut
claude plugin marketplace add DietrichGebert/ponytail
claude plugin install ponytail@ponytail
Aynı A ve B görevleri skill açıkken tekrar koşuldu:
| Girdi token (skill'siz → skill'li) | Gizli test | Diff satırı | |
|---|---|---|---|
| Pi · A | 13K → 37K (2,8×) | 4/4 | 15 → 14 |
| Pi · B | 19K → 68K (3,6×) | 5/5 | 13 → 14 |
| Claude Code · A | 212K → 290K (1,4×) | 4/4 | 12 → 15 |
| Claude Code · B | 211K → 225K (1,1×) | 5/5 | 13 → 15 |
Yazılan kod kısalmadı — bu görev seti "gereğinden fazla kod yazma" tuzağı içermiyor, ikisi de zaten hata düzeltiyordu. Kural seti ise her turda taşındığı için token maliyeti arttı; oransal artış Pi'de daha büyük çünkü Pi'nin taban promptu küçük.
"Pi'de skill pahalı" sonucuna varmayın. Oransal artış Pi'de çok daha büyük görünüyor (2,8–3,6× · Claude Code'da 1,1–1,4×) ama bunun sebebi Pi'nin taban promptunun küçük olması. Mutlak değerde ponytail'li Pi hâlâ skill'siz Claude Code'un dörtte biri kadar token harcıyor (37K–68K'ya karşı 211K–212K). Oranı değil, faturayı karşılaştırın.
Skill'in tek gerçek katkısı bir içgörü oldu. Ponytail'li Pi, kilidin içinde duran
time.sleep çağrısını fark edip kaldırdı ve şu notu bıraktı: "Redis geri gelirse bu
ikisini tek atomik SET NX olarak koy." Kilit tutarken ağ çağrısı yapmak gerçek bir
kusurdur ve skill'siz dört koşunun hiçbiri bunu görmemişti. Öte yandan o sleep
kodda açıkça "gerçek kurulumda burada Redis'e gidiliyor" diye belgelenmişti; silmek
simülasyonu ortadan kaldırdı. Skill'ler böyle çalışıyor: yeni bir bakış açısı
getiriyorlar, ama getirdikleri açıyı gözden geçirmek yine size düşüyor.
Takım kurmak: işi alt ajanlara dağıttırmak
Tek ajan yerine ajanın başka ajanlar koşturması ayrı bir eksen. Mimari fark net:
| Claude Code | Pi | |
|---|---|---|
| Alt ajan | Çekirdekte — Task aracı, .claude/agents/*.md ile rol tanımları, hook'lar | Uzantı olarak — pi install npm:pi-subagents |
| Modlar | Tek / paralel; her alt ajan izole bağlamda | Tek / paralel / zincir; her alt ajan ayrı süreçte, ön plan veya arka plan |
| Kurulum | Hazır gelir | Bir komut, ama aşağıdaki tuzak var |
Ölçmek için dört bağımsız hata içeren bir proje kuruldu (dört ayrı modül, hiçbiri diğerini etkilemiyor) ve göreve açıkça "işler bağımsız, alt ajanlara paralel dağıtabilirsin" denildi.
| Alt ajan | Süre | LLM çağrısı | Girdi token | Gizli test | |
|---|---|---|---|---|---|
| Pi | kapalı | 37s | 9 | 99K | 3/4 |
| Pi | açık | 34s | 28 | 168K | 4/4 |
| Claude Code | 1. koşu | 178s | 31 | 1.235K | 3/4 |
| Claude Code | 2. koşu | 520s | 2 | 29K | 0/4 |
Pi'de delegasyon işe yaradı. Çağrı sayısı üçe katlandı ve token %70 arttı, ama
süre artmadı — paralellik maliyeti gizledi. Dahası kalite yükseldi: tek başına
çalışırken kaçırdığı Türkçe ı/i ayrımını, o modüle ayrılmış alt ajan doğru yaptı.
İzole bağlam gerçekten işe yarıyor.
Claude Code'da delegasyon Qwen üzerinde çöktü. Aynı görev iki koşuda bambaşka davrandı: birincisinde 31 çağrı ve 1,23 milyon girdi token (her alt ajan kendi 26K'lık sistem promptunu taşıdığı için yük çarpılıyor), ikincisinde 520 saniye boyunca tek bir çağrıda 64K token üretip hiçbir dosyaya dokunmadan bitti.
Tuzak: npm i -g ile kurulan Pi'de alt ajanlar çalışmaz. Global kurulum standalone
bir bundle bırakıyor; arka plan alt ajanları ise @earendil-works/pi-server'ı global
paket klasöründe arıyor ve bulamıyor:
Background children require pi installed as the npm package … does not provide
@earendil-works/pi-server … A standalone pi binary cannot run background children.
Çözüm — eksik iki paketi global pi paketinin içine koyun:
cd /usr/lib/node_modules/@earendil-works/pi-coding-agent
npm install --no-save @earendil-works/pi-server@0.85.0 @earendil-works/pi-client@0.85.0
Bunu yapmadan Pi görevi sessizce tek başına yapar; ilk ölçümde tam olarak bu oldu (Pi durumu dürüstçe bildirdi, ama çıktıyı okumasak fark etmezdik).
Sonuç: hangisi, ne zaman
Bu ölçümden çıkardığımız üç şey:
1. Kolay işte ajan seçimi fark etmiyor. Kod düzeltme görevlerinin sekiz koşusunun sekizi de testleri tam geçti. Şaşırtıcı değil: ikisi de aynı modeli kullanıyor ve ikisinin de araç seti aynı dört temel işlemden ibaret (oku, yaz, düzenle, kabuk). İskelet, iş zorlaşana kadar görünmüyor.
2. Fark, ajanın modele bindirdiği yükte. Claude Code her turda ~26K token'lık bir sistem promptu taşıyor — bu, kendi modeli için tasarlanmış bir bütçe. 128K bağlamlı bir modelde aynı yükü her turda taşımak yalnızca pahalı değil, kırılgan: bağlamın önemli bir kısmı daha ilk turda doluyor. Toplamda 13× token ve 21× süre farkı buradan geliyor.
3. Kendi modelinizi kullanacaksanız, o varsayımı taşımayan ajanı seçin. Claude Code'un Qwen üzerindeki başarısızlıkları yavaşlık değil, tam başarısızlıktı: üç derin-teşhis koşusunun ikisinde hiç çıktı üretmeden öldü. Pi aynı görevi her seferinde 9–14 saniyede bitirdi. Gao Kaptan bağlamında sorulan soru "hangisi daha iyi bir ajan" değil, "hangisi benim modelimle çalışıyor" — ve o sorunun cevabı net.
**4. Takım işi farkı büyütüyor, kapatmıyor. Alt ajanlara dağıtım Pi'de hem işe yaradı hem kaliteyi yükseltti (3/4 → 4/4, süre sabit); Claude Code'da Qwen üzerinde bir koşuda 1,23 milyon token, diğerinde sıfır iş üretti. Sebebi aynı: her alt ajan kendi sistem promptunu taşıyor, yani tek ajanda ölçülen yük alt ajan sayısıyla çarpılıyor. Kendi modelinizle ajan takımı kuracaksanız bu, tek-ajan kıyasından daha belirleyici.
Skill'ler için kısa cevap: ikisinde de var, ikisine de aynı paket kuruluyor.** Ama skill'i varsayılan olarak açık bırakmayın — iş tipine göre açın. Bu görev setinde ponytail token'ı artırdı, kodu kısaltmadı ve karşılığında tek bir (değerli) içgörü verdi; başka bir görev setinde tablo tersine dönebilir. Ölçmeden açmak, ölçmeden kapatmak kadar yanlış.
Kategori karıştırmayın. Ponytail bir kural seti — davranışı biçimlendirir ve iki
ajanda da aynı şekilde kurulur, o yüzden adil kıyaslanabilir. ralph-claude-code gibi
otonom döngü koşucuları ise farklı bir kategoridir: ajanı tekrar tekrar çalıştırıp
kendi çıkış koşulunu yönetirler. Pi tarafındaki karşılığı pi-goal-x gibi ayrı bir
pakettir — yani onları kıyaslamak "aynı skill, iki ajan" değil, "iki farklı yaklaşım"
karşılaştırması olur.
Güvenlik: sandbox'ı Gao Kaptan sağlıyor
Pi'nin yerleşik izin sistemi yoktur. Kendi dokümanı açıkça söylüyor: dosya sistemi, süreç, ağ ve kimlik bilgilerine erişimi kısıtlayan bir katman içermez; ajan, kendisini başlatan kullanıcının tüm yetkileriyle çalışır. Claude Code'daki onay istemlerini beklemeyin.
Bu yüzden Pi'yi izole bir yerde çalıştırmak gerekir — ve bir Gao Kaptan pod'u tam olarak odur: kendi namespace'i, kendi disk alanı, varsayılan olarak kapalı internet çıkışı ve platformun ağ politikası. Ajanın yapabileceği en kötü şey o pod'la sınırlıdır.
Pi'nin paket sistemi de aynı uyarıyı taşır: pi install ile kurulan üçüncü parti paketler ve
beceriler tam sistem erişimiyle çalışır. Kaynağını görmediğiniz paketi kurmayın.
Tuzaklar
1 — Geçersiz inference anahtarı 503 döndürüyor, 401 değil. Süresi dolmuş ya da iptal
edilmiş bir anahtarla istek atınca platform "Servise şu anda ulaşılamıyor" (kind: upstream)
diyor. Bu, servisin çöktüğü izlenimi verir; oysa /v1/models aynı anda 200 dönmeye devam
eder. Model listesi geliyor ama sohbet 503 veriyorsa önce anahtarı yenileyin.
2 — models.json yeri. Yukarıda anlatıldı: $HOME/.pi/agent/, ve bu pod'larda $HOME
/home/kaptan. Aynı tuzak uv gibi başka araçlarda da geçerli.
3 — İnternet çıkışı. Pod'un allow_internet_egress bayrağı açık olmalı; npm kurulumu ve
inference çağrıları onsuz sessizce düşer. DNS her durumda çalıştığı için sorun ağ gibi
görünmez.
Ajan ekibine gerçek iş yaptırmak: GitHub'dan Kaptan'a
Paperclip ekibi GitHub'daki issue'ları alsın, kodu yazsın, PR'ı incelesin, birleştirsin ve sonucu Kaptan'da pod olarak yayına alsın — siz yalnızca issue açın.
Kendi GitHub repo'nuz
Boş bir Ubuntu pod'una kendi GitHub repo'nuzu klonlayın, çalıştırın ve portunu dışarı açın.