 Gao Kaptan Docs
Claude Code'u kendi modelinizle çalıştırın
 Claude Code'u kendi modelinizle çalıştırın
Kaptan'daki Qwen'i Claude Code'un arkasına koyun: kod tek satır dışarı çıkmadan yazılsın, test edilsin, düzeltilsin.
Claude Code bir terminal ajanıdır: dosya okur, yazar, komut çalıştırır, testin sonucunu görüp kendi kodunu düzeltir. Varsayılan olarak Anthropic'in sunucularına konuşur — yani kodunuz dışarı çıkar. Bu sayfa onu kendi kurumunuzdaki Qwen'e bağlıyor. Ajan aynı ajan kalıyor, ama ne istem ne kod Gao Kaptan'ın dışına çıkıyor.
Kurulan zincir üç parçadan ibaret:
Claude Code            (Anthropic biçimi konuşur)
   │
   ▼
LiteLLM  /v1/messages  (Anthropic → OpenAI çevirisi)
   │
   ▼
vLLM     /v1/chat/...  (Qwen3.8-27B-FP8, tek MIG dilimi)
Ortadaki köprü işin tamamıdır. LiteLLM'in /v1/messages ucu Anthropic'in mesaj biçimini kabul
edip OpenAI biçimine çevirir; Claude Code karşısında gerçek bir Anthropic sunucusu olduğunu
sanır.
Elle kurmak istemiyorsanız: bu zincirin tamamı Atölye → Claude Code tarifiyle tek tıkla kuruluyor. Üç seçenek sunar — Gao Kaptan Inference (ön koşul yok), kendi vLLM pod'unuz, ya da hazır LiteLLM kapınız. Aşağıdaki adımlar aynı kurulumun elle yapılışıdır; neyin neden öyle olduğunu görmek isterseniz okumaya devam edin.
Pod "Running" göründüğü an CLI henüz hazır olmayabilir. Ajan pod'u açılışta kendini kuruyor ve bu ölçülen 30 saniye sürüyor:
| Aşama | Süre |
|---|---|
apt-get update | 1 sn |
| Paket kurulumu (curl, git, python3, tar) | 13 sn |
| Sürüm çözümü | 0 sn |
| İndirme (102 MB) | 11 sn |
| Açma (327 MB) | 3 sn |
| Toplam | 28 sn |
O yarım dakika içinde terminali açarsanız üstte Claude Code kuruluyor… satırını görürsünüz;
satır kaybolunca kurulum bitmiştir. Pod loglarında da Claude Code X.Y.Z hazir. yazar.
Bu sayfadaki tek kritik ayar --tool-call-parser. Yanlış seçerseniz hiçbir şey hata
vermez — ajan "dosyayı oluşturuyorum" der, hiçbir dosya oluşmaz. Sebebi aşağıda.
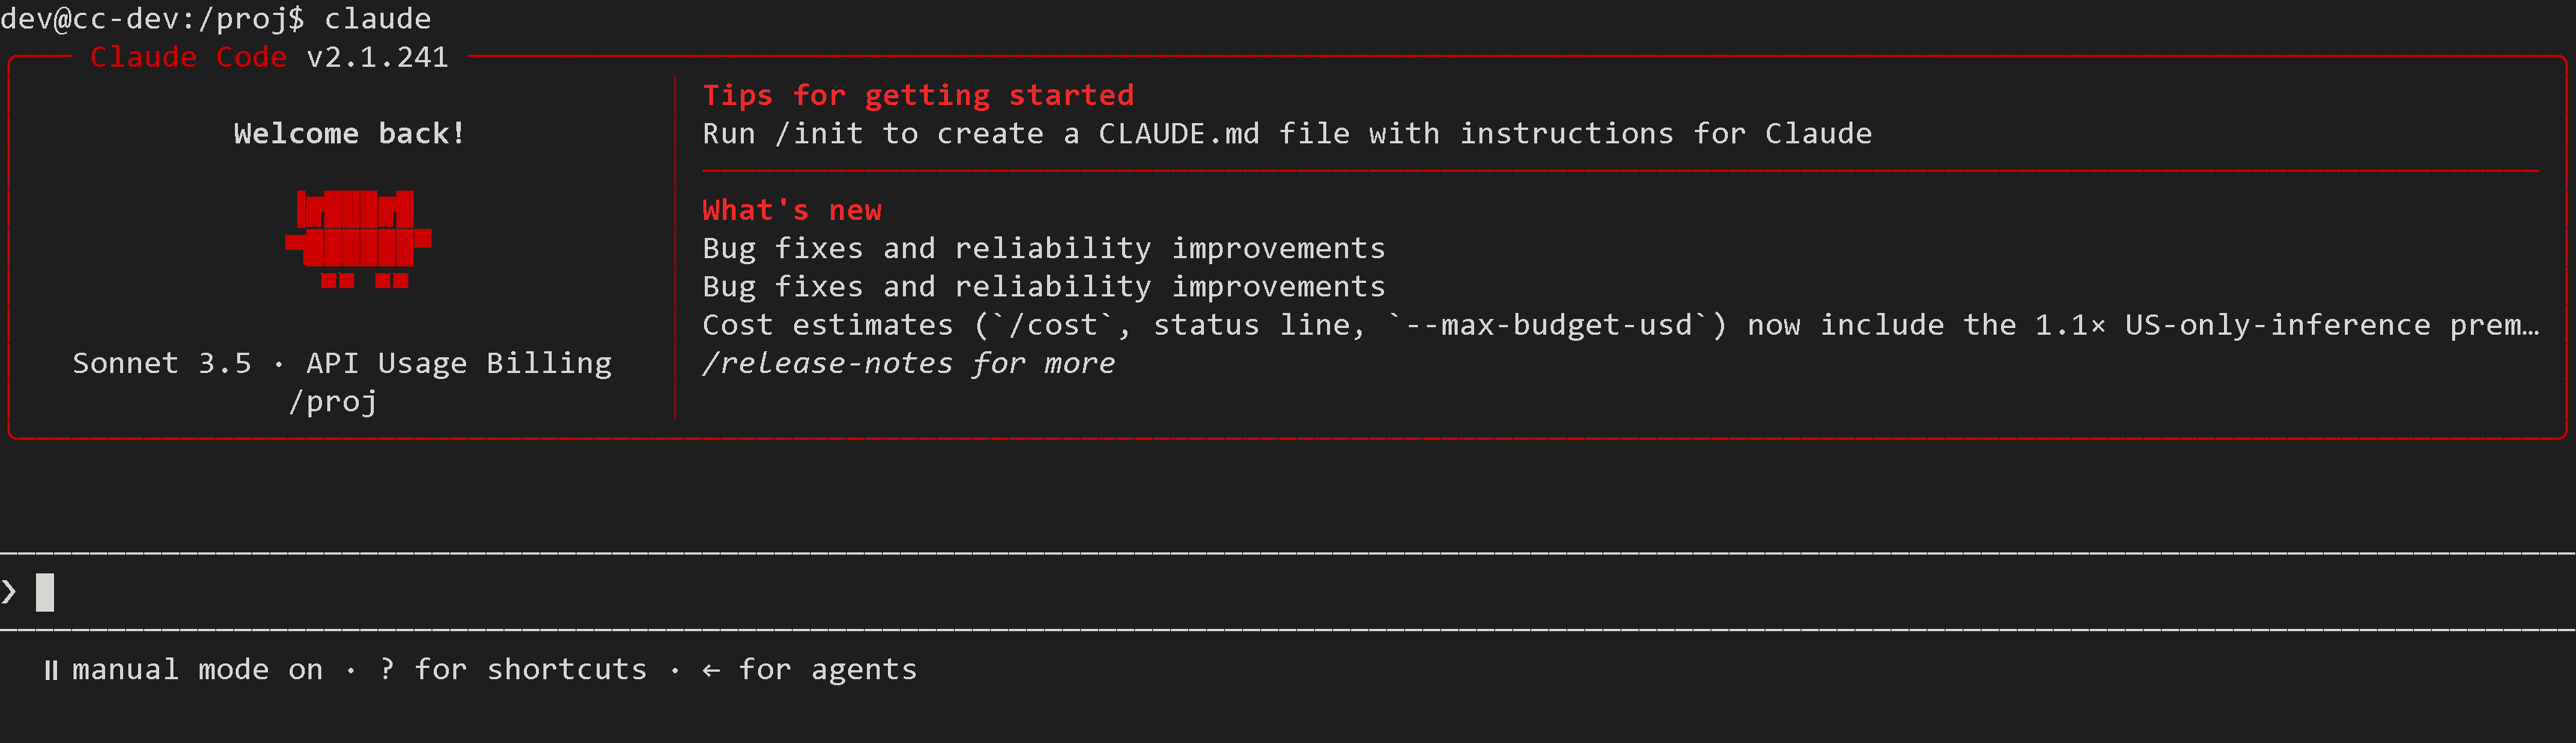
Sonuç, Gao Kaptan'ın kendi pod terminalinde şuna benziyor — ekrandaki tek "Anthropic" şey maskot; istek arka planda bizim Qwen'e gidiyor:
Ne kadar iyi çalışıyor
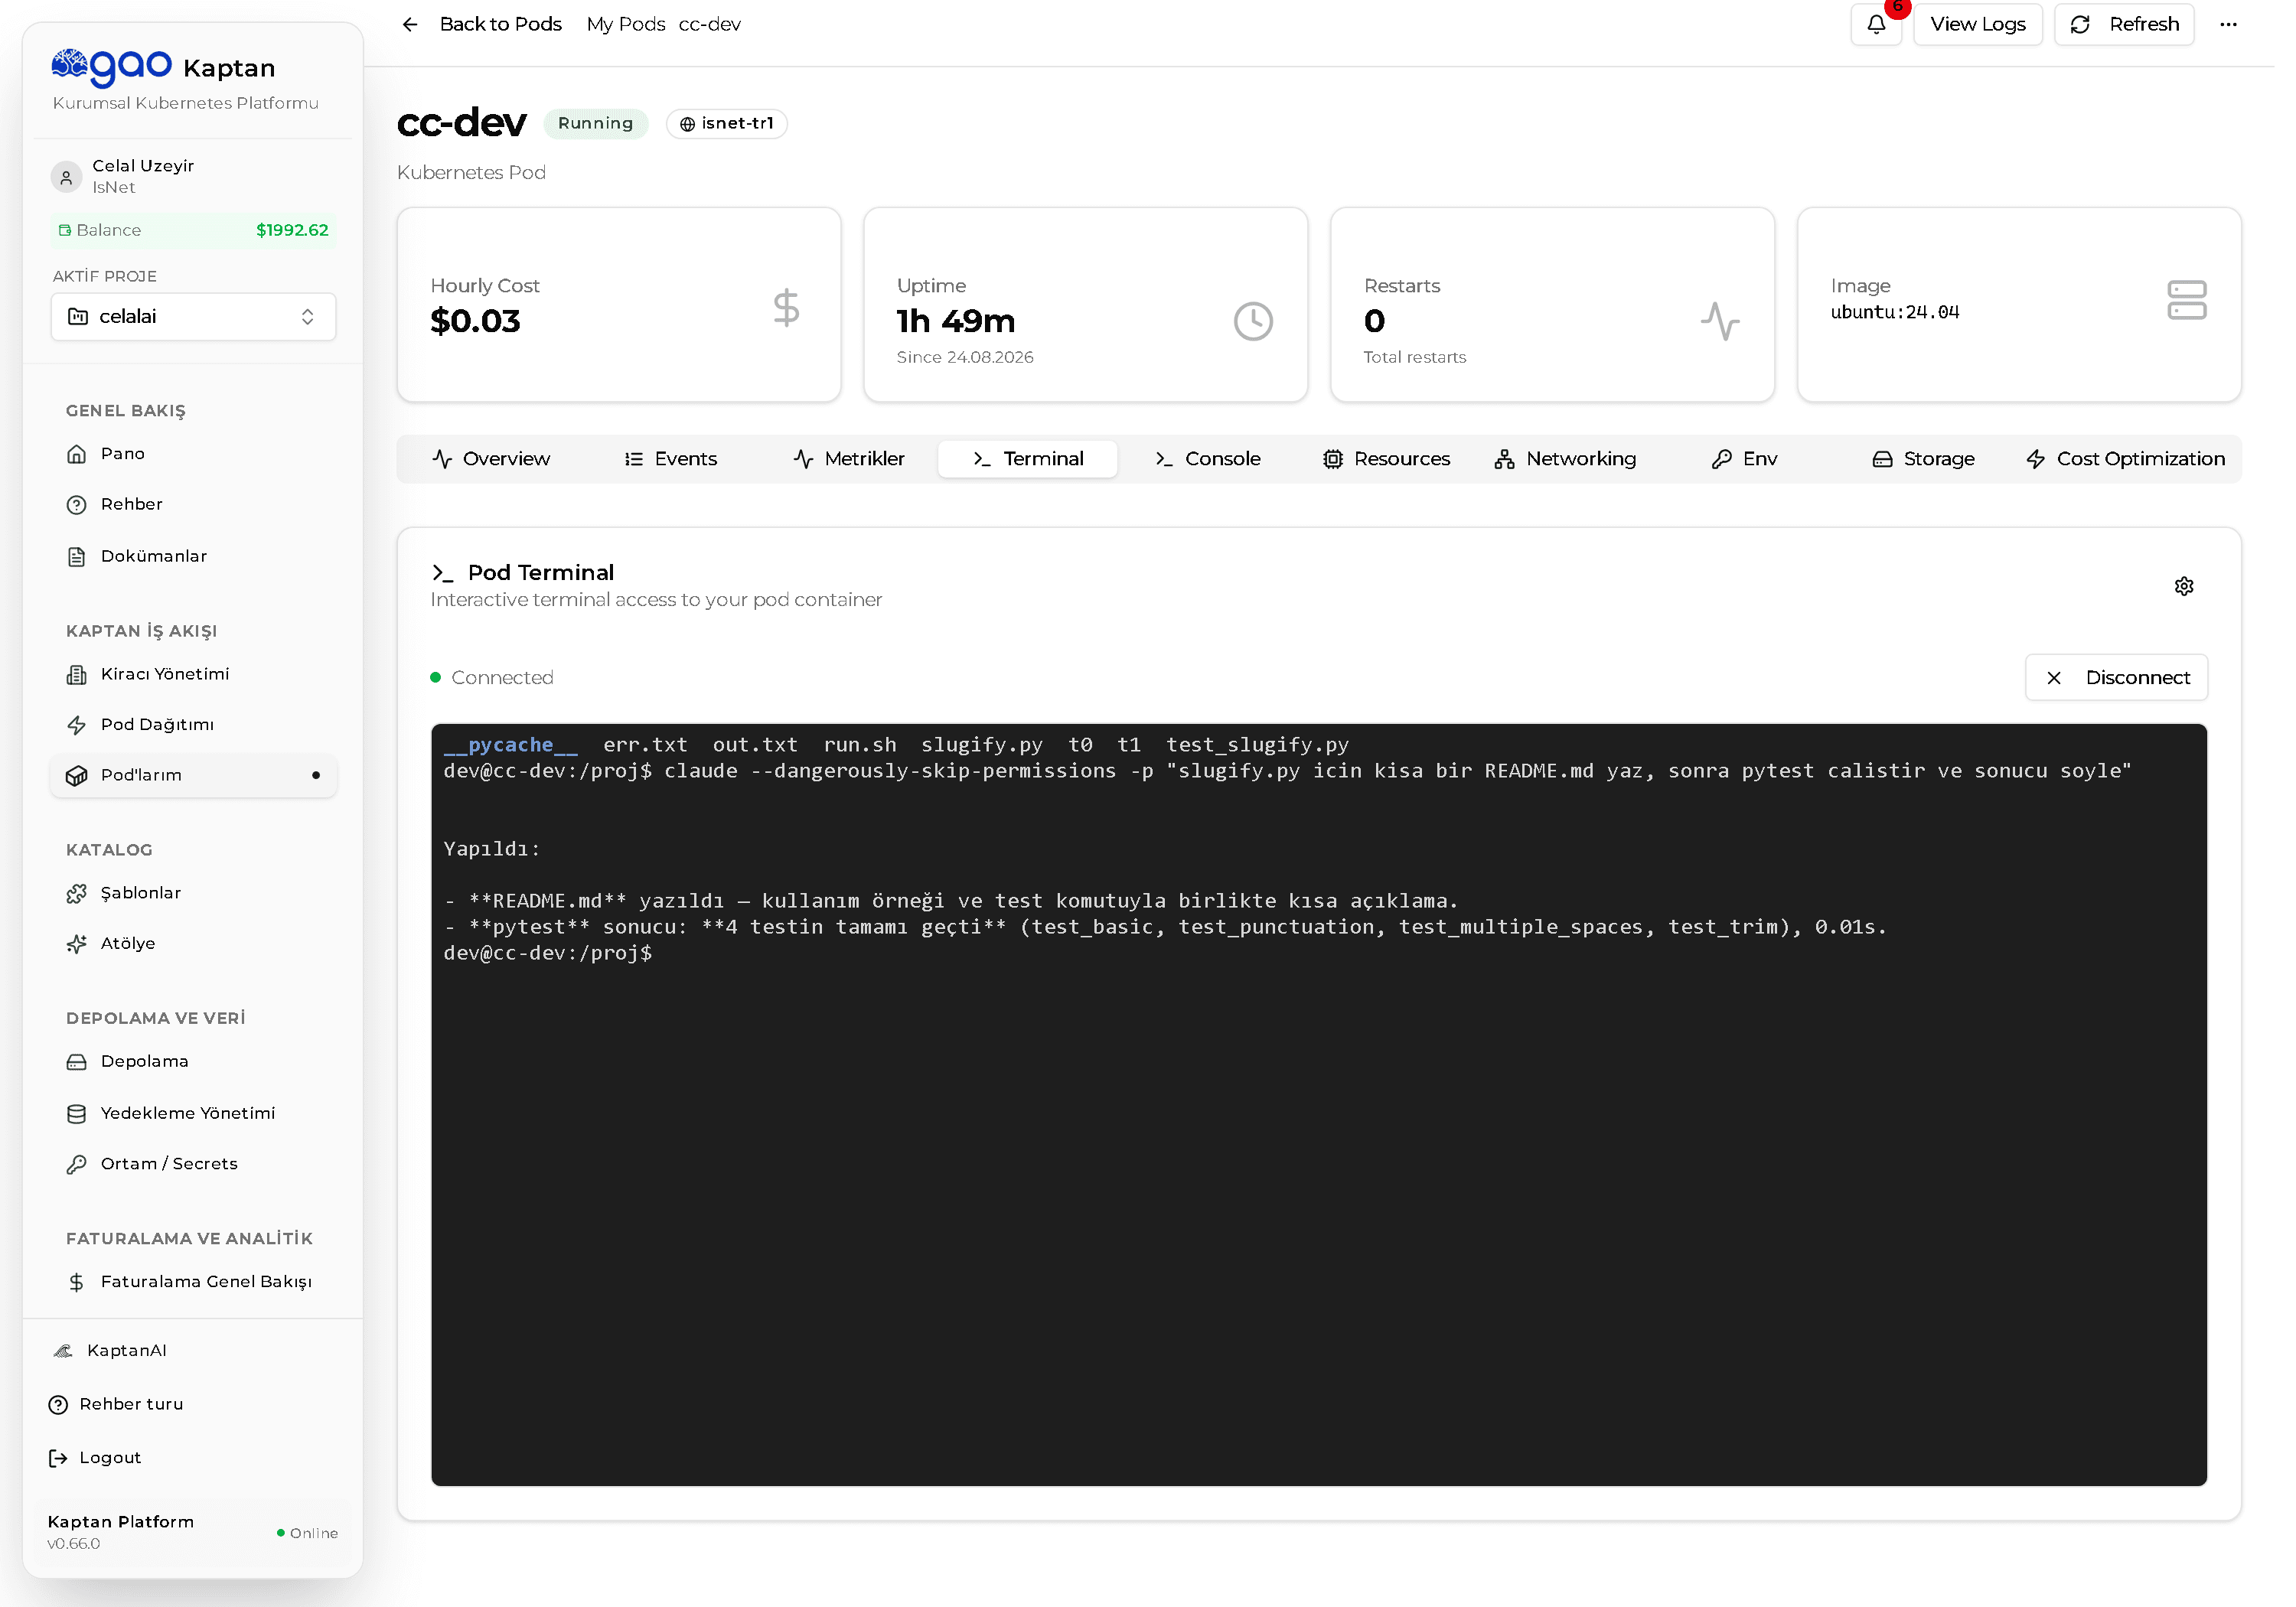
Sayılar tek bir H200 NVL 4g.71gb diliminden. Ajana kasten eksik bir slugify.py ve ona ait
dört test verildi, "testleri değiştirmeden geçir" dendi:
| Aşama | Sonuç |
|---|---|
| pytest çalıştırdı, başarısız testleri gördü | ✅ |
slugify.py'yi düzeltti (noktalama, çoklu boşluk, trim) | ✅ |
| Testlere dokunmadı | ✅ |
| Tekrar çalıştırıp doğruladı | ✅ 4 passed |
| Toplam süre | 43 saniye |
Yani tek bir araç çağrısı değil, kapanan bir döngü: oku → çalıştır → hatayı gör → düzelt → tekrar çalıştır.
Modeli açın
Qwen3.8 27B (FP8, vLLM) sayfasındaki pod'un aynısı — tek farkla: sonuna araç çağrısı bayrakları ekleniyor.
- İmaj:
vllm/vllm-openai:latest - GPU: MIG
4g.71gb× 1 · Kaynak: 8 vCPU / 40 GB RAM - Kalıcı disk:
/data,HF_HOME=/data/hf(ağırlıklar bir kez insin) - Port: 8000 · İnternet: açık
vllm serve Qwen/Qwen3.8-27B-FP8 \
  --tensor-parallel-size 1 \
  --kv-cache-dtype fp8 \
  --enable-prefix-caching \
  --prefix-match-unit 16 \
  --reasoning-parser qwen3 \
  --host 0.0.0.0 --port 8000 \
  --max-model-len 65536 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_xml
--enable-auto-tool-choice modelin kendi kararıyla araç çağırmasına izin verir;
--tool-call-parser qwen3_xml ise modelin ürettiği metni araç çağrısına çevirir. İkincisi
olmadan birincisi işe yaramaz.
Ağırlıklar kalıcı diskte olsa bile yükleme yaklaşık 5 dakika sürer. /health 200 dönmeden
köprüyü denemeyin.
Köprüyü kurun
İkinci pod, GPU'suz:
- İmaj:
ghcr.io/berriai/litellm:v1.90.2 - Kaynak: 4 vCPU / 6 GB RAM · Port: 4000 — bu sayfadaki ölçümler bu boyutta alındı; köprü GPU'ya dokunmuyor, işi sadece biçim çevirisi
- Ortam değişkenleri:
LITELLM_MASTER_KEY= kendi seçtiğiniz anahtar (örn.sk-cc-...),DISABLE_SCHEMA_UPDATE=true— arkasında Postgres olmadığı için; bu olmazsa LiteLLM açılışta şema göçü yapmaya çalışır - Dış erişim: kapalı — küme içinden konuşulacak
Dosya olarak /app/proxy_server_config.yaml:
model_list:
  - model_name: claude-sonnet-4-5
    litellm_params:
      model: hosted_vllm/Qwen/Qwen3.8-27B-FP8
      api_base: http://qwen-cc-svc:8000/v1
      api_key: none
      max_parallel_requests: 8
      # SART - asagidaki uyariya bakin. Bu olmadan akis imzasiz bir `thinking`
      # blogu tasiyor ve Claude Code "stream was malformed" deyip dusuyor.
      extra_body:
        chat_template_kwargs:
          enable_thinking: false

litellm_settings:
  drop_params: true
  request_timeout: 600
  json_logs: true          # model adini loglardan okuyabilmek icin

general_settings:
  master_key: sk-cc-...
Komut:
sh -lc "exec litellm --config /app/proxy_server_config.yaml --port 4000 --num_workers 2"Takma ad, tek turda üretilebilecek token sayısını belirler. Claude Code'un içinde bir
model→azami-çıktı tablosu var ve isteğin max_tokens değerini ona göre kırpıyor —
CLAUDE_CODE_MAX_OUTPUT_TOKENS ile yükseltmeye çalışsanız bile. Giden istek gövdelerini
yakalayarak ölçtük:
ANTHROPIC_MODEL | env yok | CLAUDE_CODE_MAX_OUTPUT_TOKENS=16000 |
|---|---|---|
claude-3-5-sonnet-20241022 | 8192 | 8192 |
claude-sonnet-4-5 | 32000 | 64000 |
tanınmayan ad (örn. kaptan-qwen) | 32000 | 64000 ama çalışmaz |
Gerçek Anthropic API'de 3.5 Sonnet'in çıktı tavanı 8192 olduğu için o adı seçmek, modeliniz
çok daha fazlasını üretebilse bile sizi 8192'ye hapseder. Tanınmayan bir ad ise tavanı açar
ama ajan hiçbir yanıt üretmez — Claude Code adı tablosunda bulamayınca "bu modeli
tanımıyorum" uyarısı verip boş dönüyor. Bu yüzden takma ad claude-sonnet-4-5.
Takma ad hangi modelin çalıştığını değil, Claude Code'un ne diye soracağını anlatır —
ANTHROPIC_MODEL ile burada aynı adı yazmanız yeterli.
MAX_THINKING_TOKENS=0 şart. claude-sonnet-4-5 adıyla Claude Code isteğe
thinking: {budget_tokens: 63999, display: omitted} ekliyor. Bu yolda modelin ürettiği her
şey düşünce bloğuna düşüyor, ekrana metin gelmiyor: ajan sessizce hiçbir şey yapmıyor,
hata da vermiyor. Düşünmeyi kapattığınız anda hem yanıt hem araç çağrıları geri geliyor —
ölçüldü.
api_base içindeki qwen-cc-svc, ilk pod'un adından türeyen küme içi servis adıdır. Pod'un
adını değiştirirseniz burayı da değiştirin — yoksa köprü ayağa kalkar, sağlık ucu 200 döner,
ama hiçbir istek tamamlanmaz.
Geliştirme pod'unu açın
Üçüncü pod, ajanın içinde çalışacağı yer:
- İmaj:
ubuntu:24.04· Komut:sleep infinity - Kaynak: 2 vCPU / 4 GB RAM · İnternet: açık (Node ve Claude Code inecek)
sleep infinity şart. Komutsuz bir ubuntu imajı hemen çıkar, pod da yeniden başlatma
döngüsüne girer.
Terminalden:
apt-get update -qq && apt-get install -y -qq curl git python3
curl -fsSL https://deb.nodesource.com/setup_22.x | bash -
apt-get install -y nodejs
npm install -g @anthropic-ai/claude-code
Ajanı köprüye bağlayın
Claude Code'un hedefini değiştiren ortam değişkenleri:
export ANTHROPIC_BASE_URL=http://cc-bridge-svc:4000
export ANTHROPIC_AUTH_TOKEN=sk-cc-...
export ANTHROPIC_MODEL=claude-sonnet-4-5
export ANTHROPIC_SMALL_FAST_MODEL=claude-sonnet-4-5
export MAX_THINKING_TOKENS=0             # faydali ama YETMEZ - asagiya bakin
export CLAUDE_CODE_MAX_OUTPUT_TOKENS=16000   # pencereden DUSER - asagiya bakin
CLAUDE_CODE_MAX_OUTPUT_TOKENS neden 16000? Bu değer modelin bağlam penceresinden düşüyor (sınır istem + max_tokens toplamına uygulanıyor); 64000 yazmak ajanı bozuk akışla düşürüyordu. Ölçüm ve tablo: Paperclip örneği.
Düşünmeyi kapatmanın yeri köprü, MAX_THINKING_TOKENS değil. Bu sayfa bir süre
MAX_THINKING_TOKENS=0'ı tek başına "şart" diye yazdı; ölçüm bunu desteklemiyor.
MAX_THINKING_TOKENS istemci tarafı bir ayardır — Claude Code'un ne istediğini
değiştirir. Düşünmeyi üreten şey modelin sunucu tarafındaki sohbet şablonudur: köprüye
düşünme istemeyen düz bir HTTP isteği atıldığında da yanıt thinking bloğu taşıyor.
O blok Anthropic akışında imzasız geldiği için (content_block_start →
{"type":"thinking","signature":""}) Claude Code akışı "API Error: The response stream
was malformed" diye reddediyor. Gerçek çözüm köprü config'indeki
chat_template_kwargs: {enable_thinking: false} satırıdır; yukarıdaki config'de var.
Ajanı bir orkestratör (ör. Paperclip) sürüyorsa belirti daha da sessiz olur: koşum
adapter_failed ile düşer, hiç token harcanmaz ve panoda sebep görünmez.
SMALL_FAST_MODEL zorunlu değil — ölçtük: onu hiç vermeden yapılan bir koşu sorunsuz
tamamlandı (EXIT=0, aynı süre). Claude Code bu adı özet/başlık gibi yardımcı işler için
kullanır, o yüzden yine de tanımlamak iyi olur; ama unuttunuz diye ajan durmaz.
Tek seferlik bir iş için:
claude -p "fizzbuzz.py olustur, calistir, ciktisini goster"Ya da normal, etkileşimli oturum için sadece:
claudeİlk açılışta tema seçimi, güvenlik notu ve "bu klasöre güveniyor musunuz?" adımları gelir; sonrası her zamanki Claude Code.
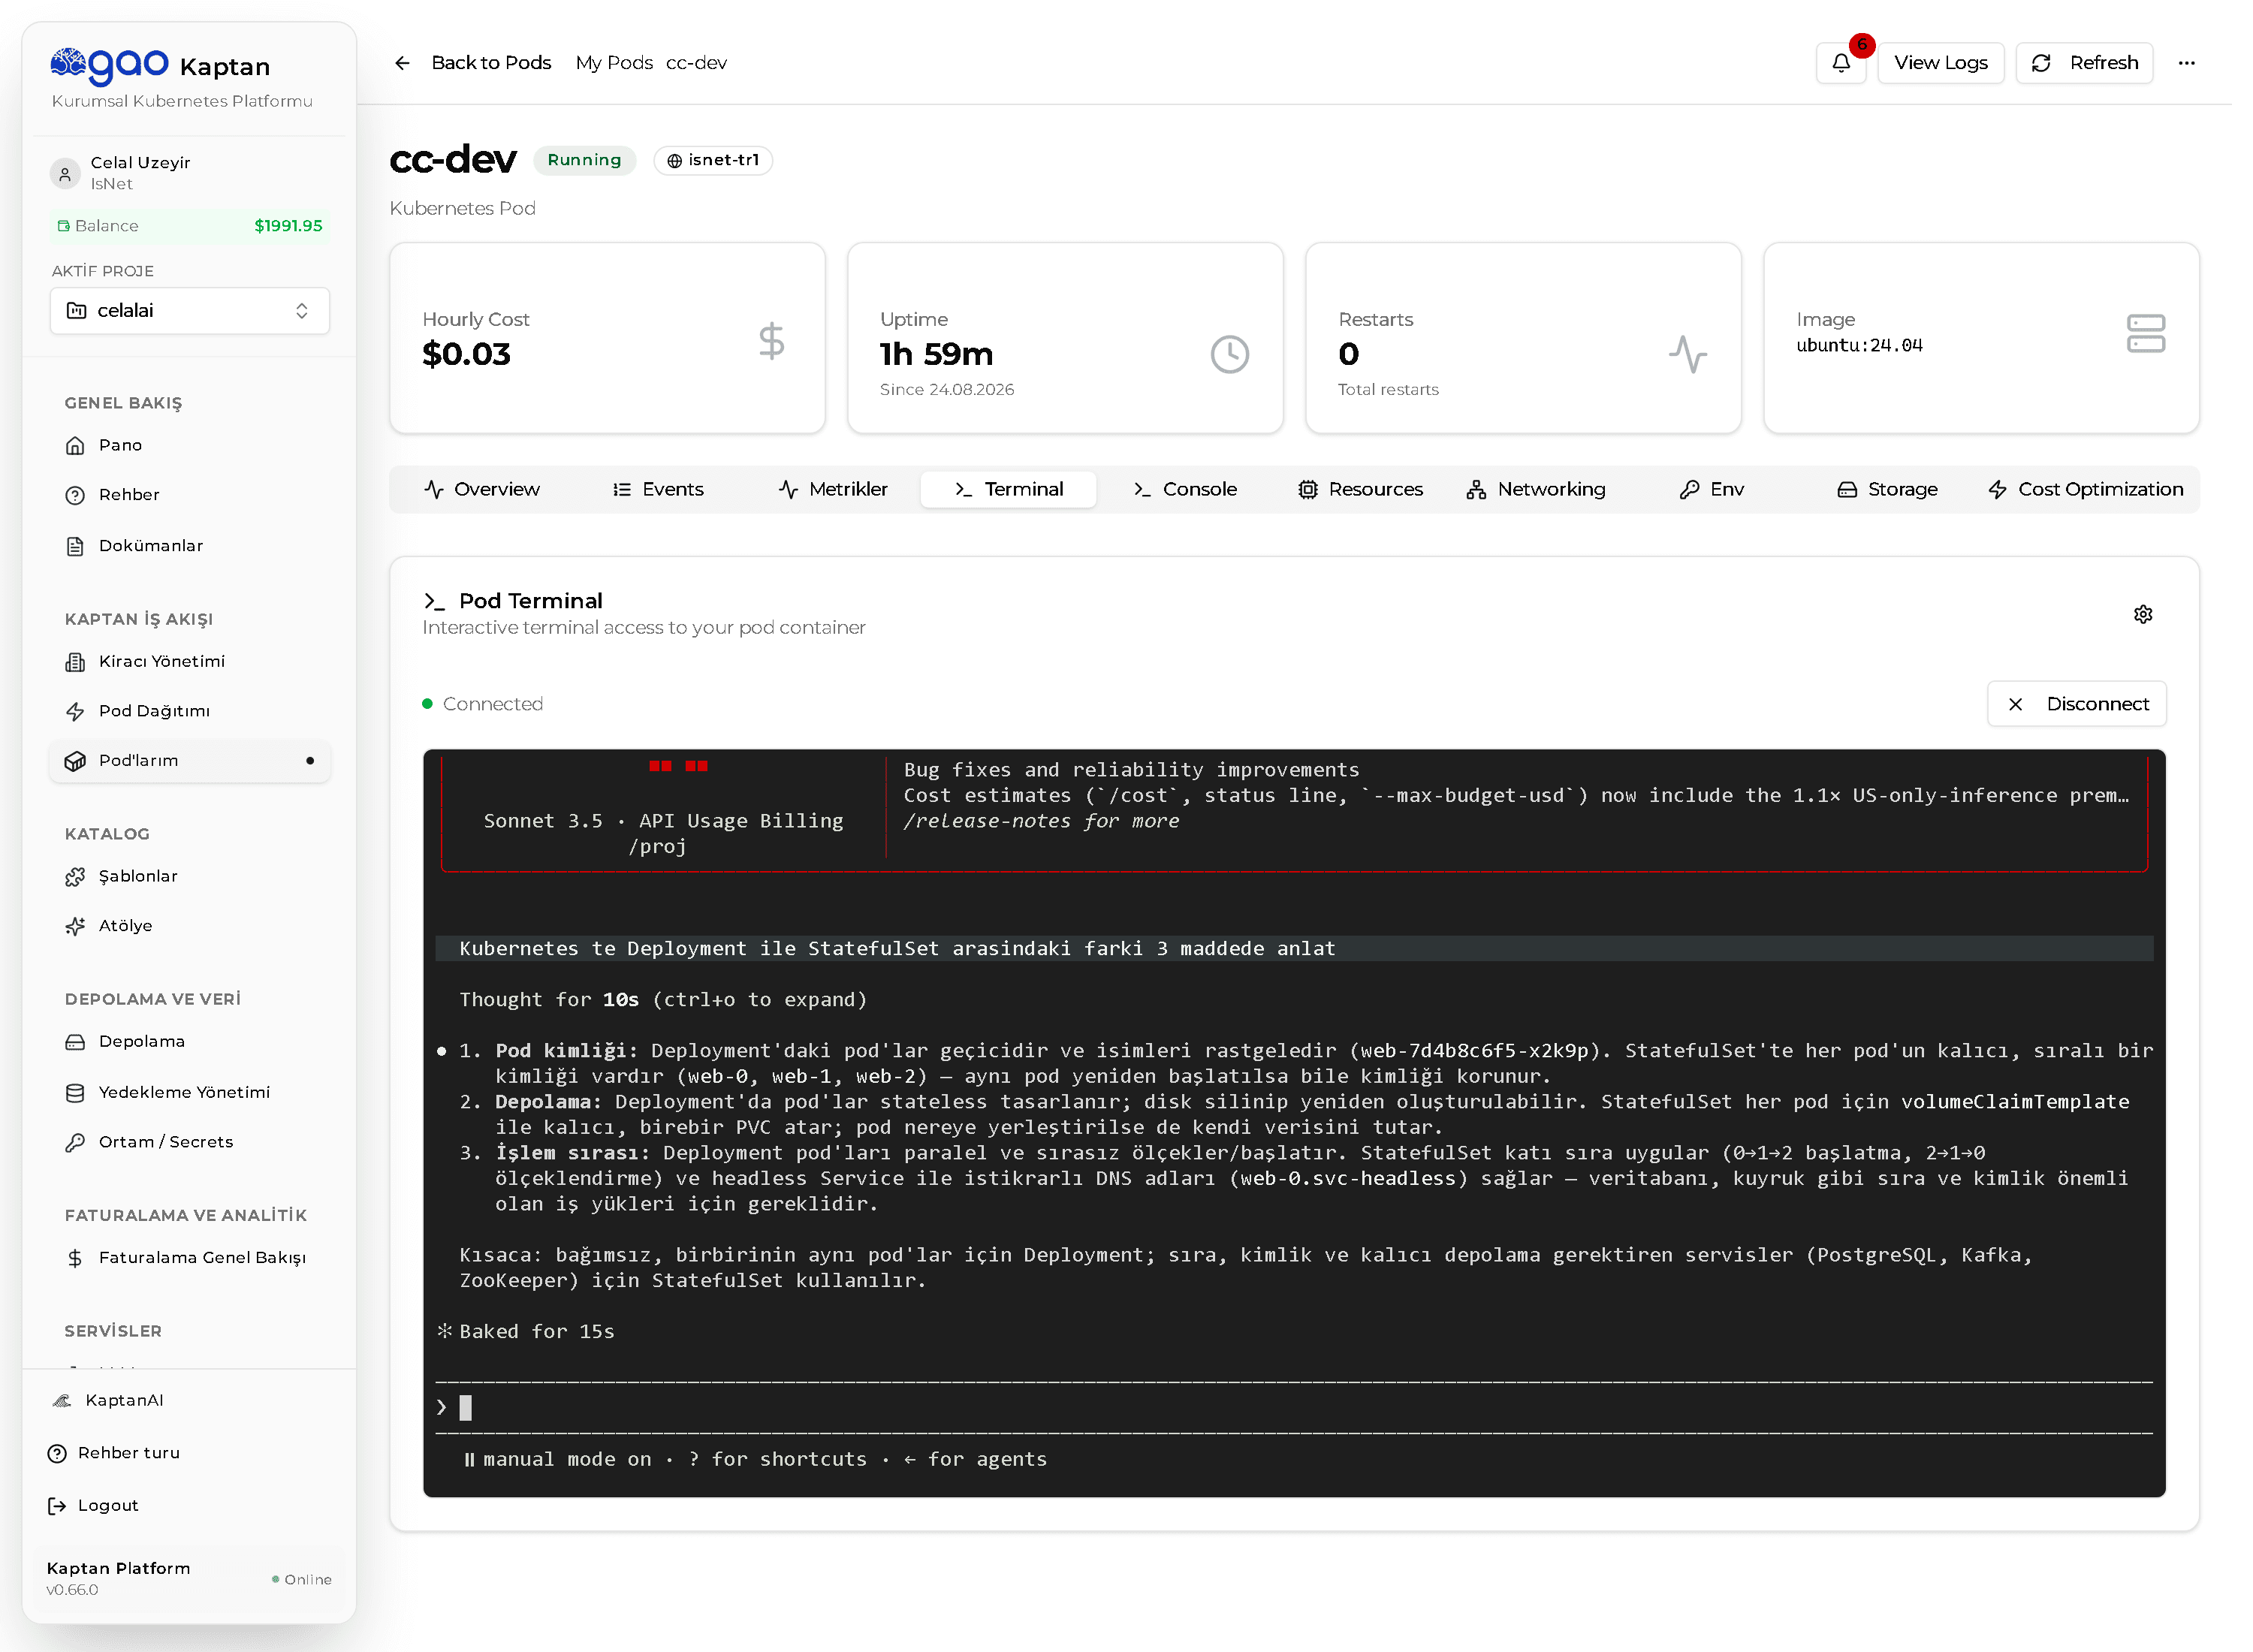
En sinsi tuzak: yanlış araç ayrıştırıcısı
İlk denememizde --tool-call-parser hermes yazmıştık. Hata alınmadı, model cevap verdi, ajan
"fizzbuzz.py dosyasını oluşturup çalıştıracağım" dedi — ve hiçbir dosya oluşmadı.
Sebep yanıtın içindeydi. stop_reason tool_use değil end_turn geliyordu ve araç çağrısı
düz metin bloğunun içinde duruyordu:
<tool_call>
<function=write_file>
<parameter=path>/tmp/a.txt</parameter>
<parameter=content>merhaba</parameter>
Qwen bu XML biçimini üretir; hermes ayrıştırıcısı ise JSON bekler. Eşleşme olmayınca vLLM
metni olduğu gibi geçirir — kimse hata vermez, çünkü teknik olarak bir hata yok. Ajan
"araç yok" diye anlar ve niyetini anlatmakla yetinir.
Doğru ayrıştırıcıyla aynı istek şuna döner:
stop_reason = tool_use
--- blok: thinking
--- blok: tool_use   name=write_file  input={"path": "/tmp/a.txt", "content": "merhaba"}
Kuralı şöyle koyun: araç çağrısı çalışmıyorsa önce kurulumu değil, tek araçlı bir isteğin
stop_reason'ına bakın. end_turn görüyorsanız sorun ayrıştırıcıdadır.
vLLM'in tanıdığı adları kendi sürümünüzden okuyabilirsiniz — --help bu listeyi göstermez:
python3 -c "from vllm.tool_parsers import ToolParserManager as M; print(sorted(M.lazy_parsers))"Qwen3 ailesi için qwen3_xml (eşdeğeri qwen3_coder) doğru cevaptır.
Root ile --dangerously-skip-permissions çalışmaz. Claude Code root/sudo altında bu
bayrağı güvenlik gerekçesiyle reddeder ve çıkar. Pod'da normal bir kullanıcı açın:
useradd -m -s /bin/bash dev && chown -R dev:dev /proj
su - dev -c 'cd /proj && claude --dangerously-skip-permissions -p "..."'
/model menüsü yalan söylüyor
/model yazdığınızda Claude Code kendi model listesini gösterir — Opus, Sonnet, Haiku, hepsi
fiyatlarıyla. Bu liste sizin köprünüzden gelmiyor. Gerçekte çalışan tek satır, model_list
içinde tanımladığınız takma addır; ekranda işaretli duran satır odur.
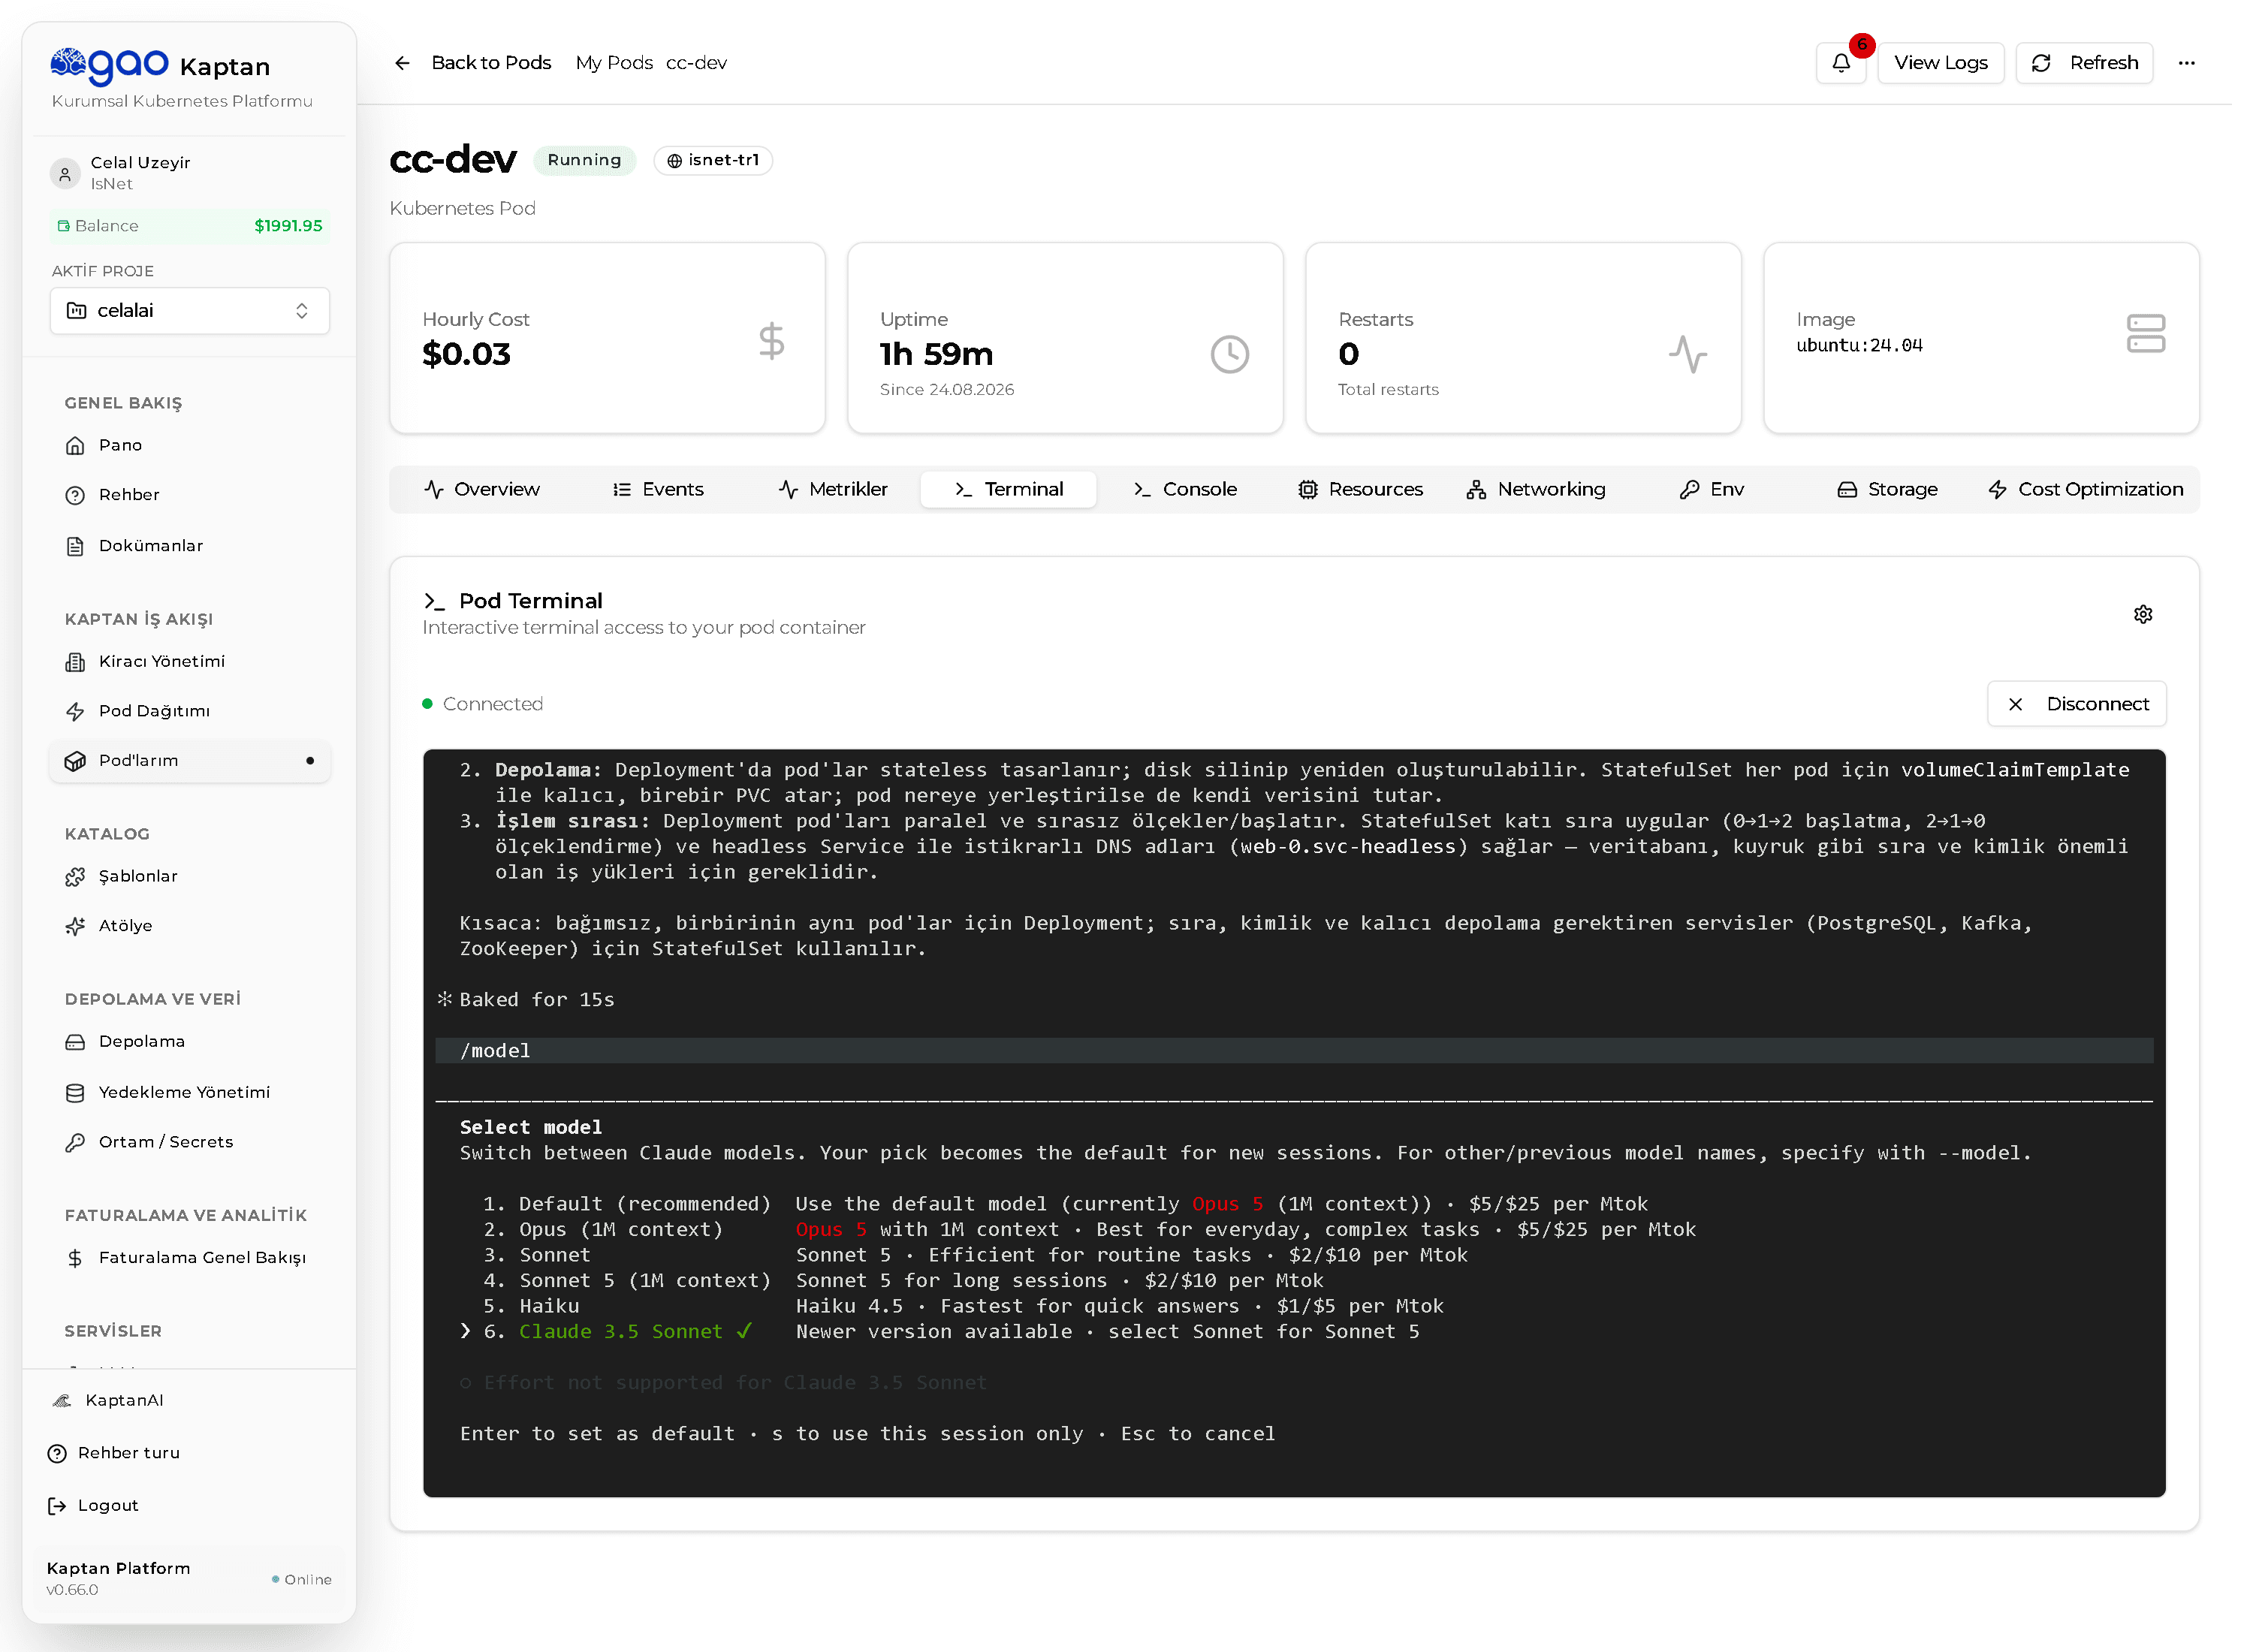
Listeden başka bir satır seçerseniz köprü o adı tanımaz. Ölçtük — hata net ve koşu ölür:
API Error: 400 {'error': 'anthropic_messages: Invalid model name passed in
model=claude-opus-5. Call `/v1/models` to view available models for your key.'}
EXIT=1
Birden fazla model sunmak istiyorsanız çözüm menüde değil, köprüde: model_list'e ikinci bir
takma ad ekleyin.
model_list:
  - model_name: claude-sonnet-4-5      # varsayilan
    litellm_params:
      model: hosted_vllm/Qwen/Qwen3.8-27B-FP8
      api_base: http://qwen-cc-svc:8000/v1
      extra_body: {chat_template_kwargs: {enable_thinking: false}}
  - model_name: <menuden-secince-gelen-ad>      # asagiya bakin
    litellm_params:
      model: hosted_vllm/Qwen/Qwen3.6-35B-A3B-FP8
      api_base: http://qwen-fast-svc:8000/v1
      extra_body: {chat_template_kwargs: {enable_thinking: false}}
Gönderdiğiniz ad, köprüye giden ad olmayabilir. Claude Code eski model adlarını sessizce
yenisine çeviriyor. Yukarıdaki hatayı üreten deneyde ANTHROPIC_MODEL=claude-opus-4-20250514
verilmişti; köprüye ulaşan ad claude-opus-5 oldu:
⚠ claude-opus-4-20250514 is automatically remapped to Opus 5 (the latest Opus).
  Set CLAUDE_CODE_DISABLE_LEGACY_MODEL_REMAP=1 to keep the requested model.
Bu yüzden takma adı tahmin etmeyin. Ya CLAUDE_CODE_DISABLE_LEGACY_MODEL_REMAP=1 verip adı
sabitleyin, ya da bir istek gönderip köprünün loglarından gerçekte hangi adın geldiğini okuyun
ve model_name'i ona eşitleyin.
Web'e erişim: biri çalışıyor, biri çalışmıyor
Ajanın güncel bilgiye ulaşması gerektiğinde iki yol var ve bu kurulumda ikisi aynı şekilde davranmıyor.
| Araç | Durum | Sebep |
|---|---|---|
| Web Search | ❌ | Sunucu taraflı bir araç. LiteLLM Anthropic→OpenAI çevirisinde tools boşalıyor ama tool_choice kalıyor; vLLM 400 — When using tool_choice, tools must be set döndürüyor |
| Fetch | ✅ | İstemci taraflı — adresi CLI'ın kendisi çekiyor, modelin bir şey yapması gerekmiyor |
İyi haber: ajan bunu kendisi de fark ediyor. Arama patlayınca doğrudan kaynağa gidiyor.
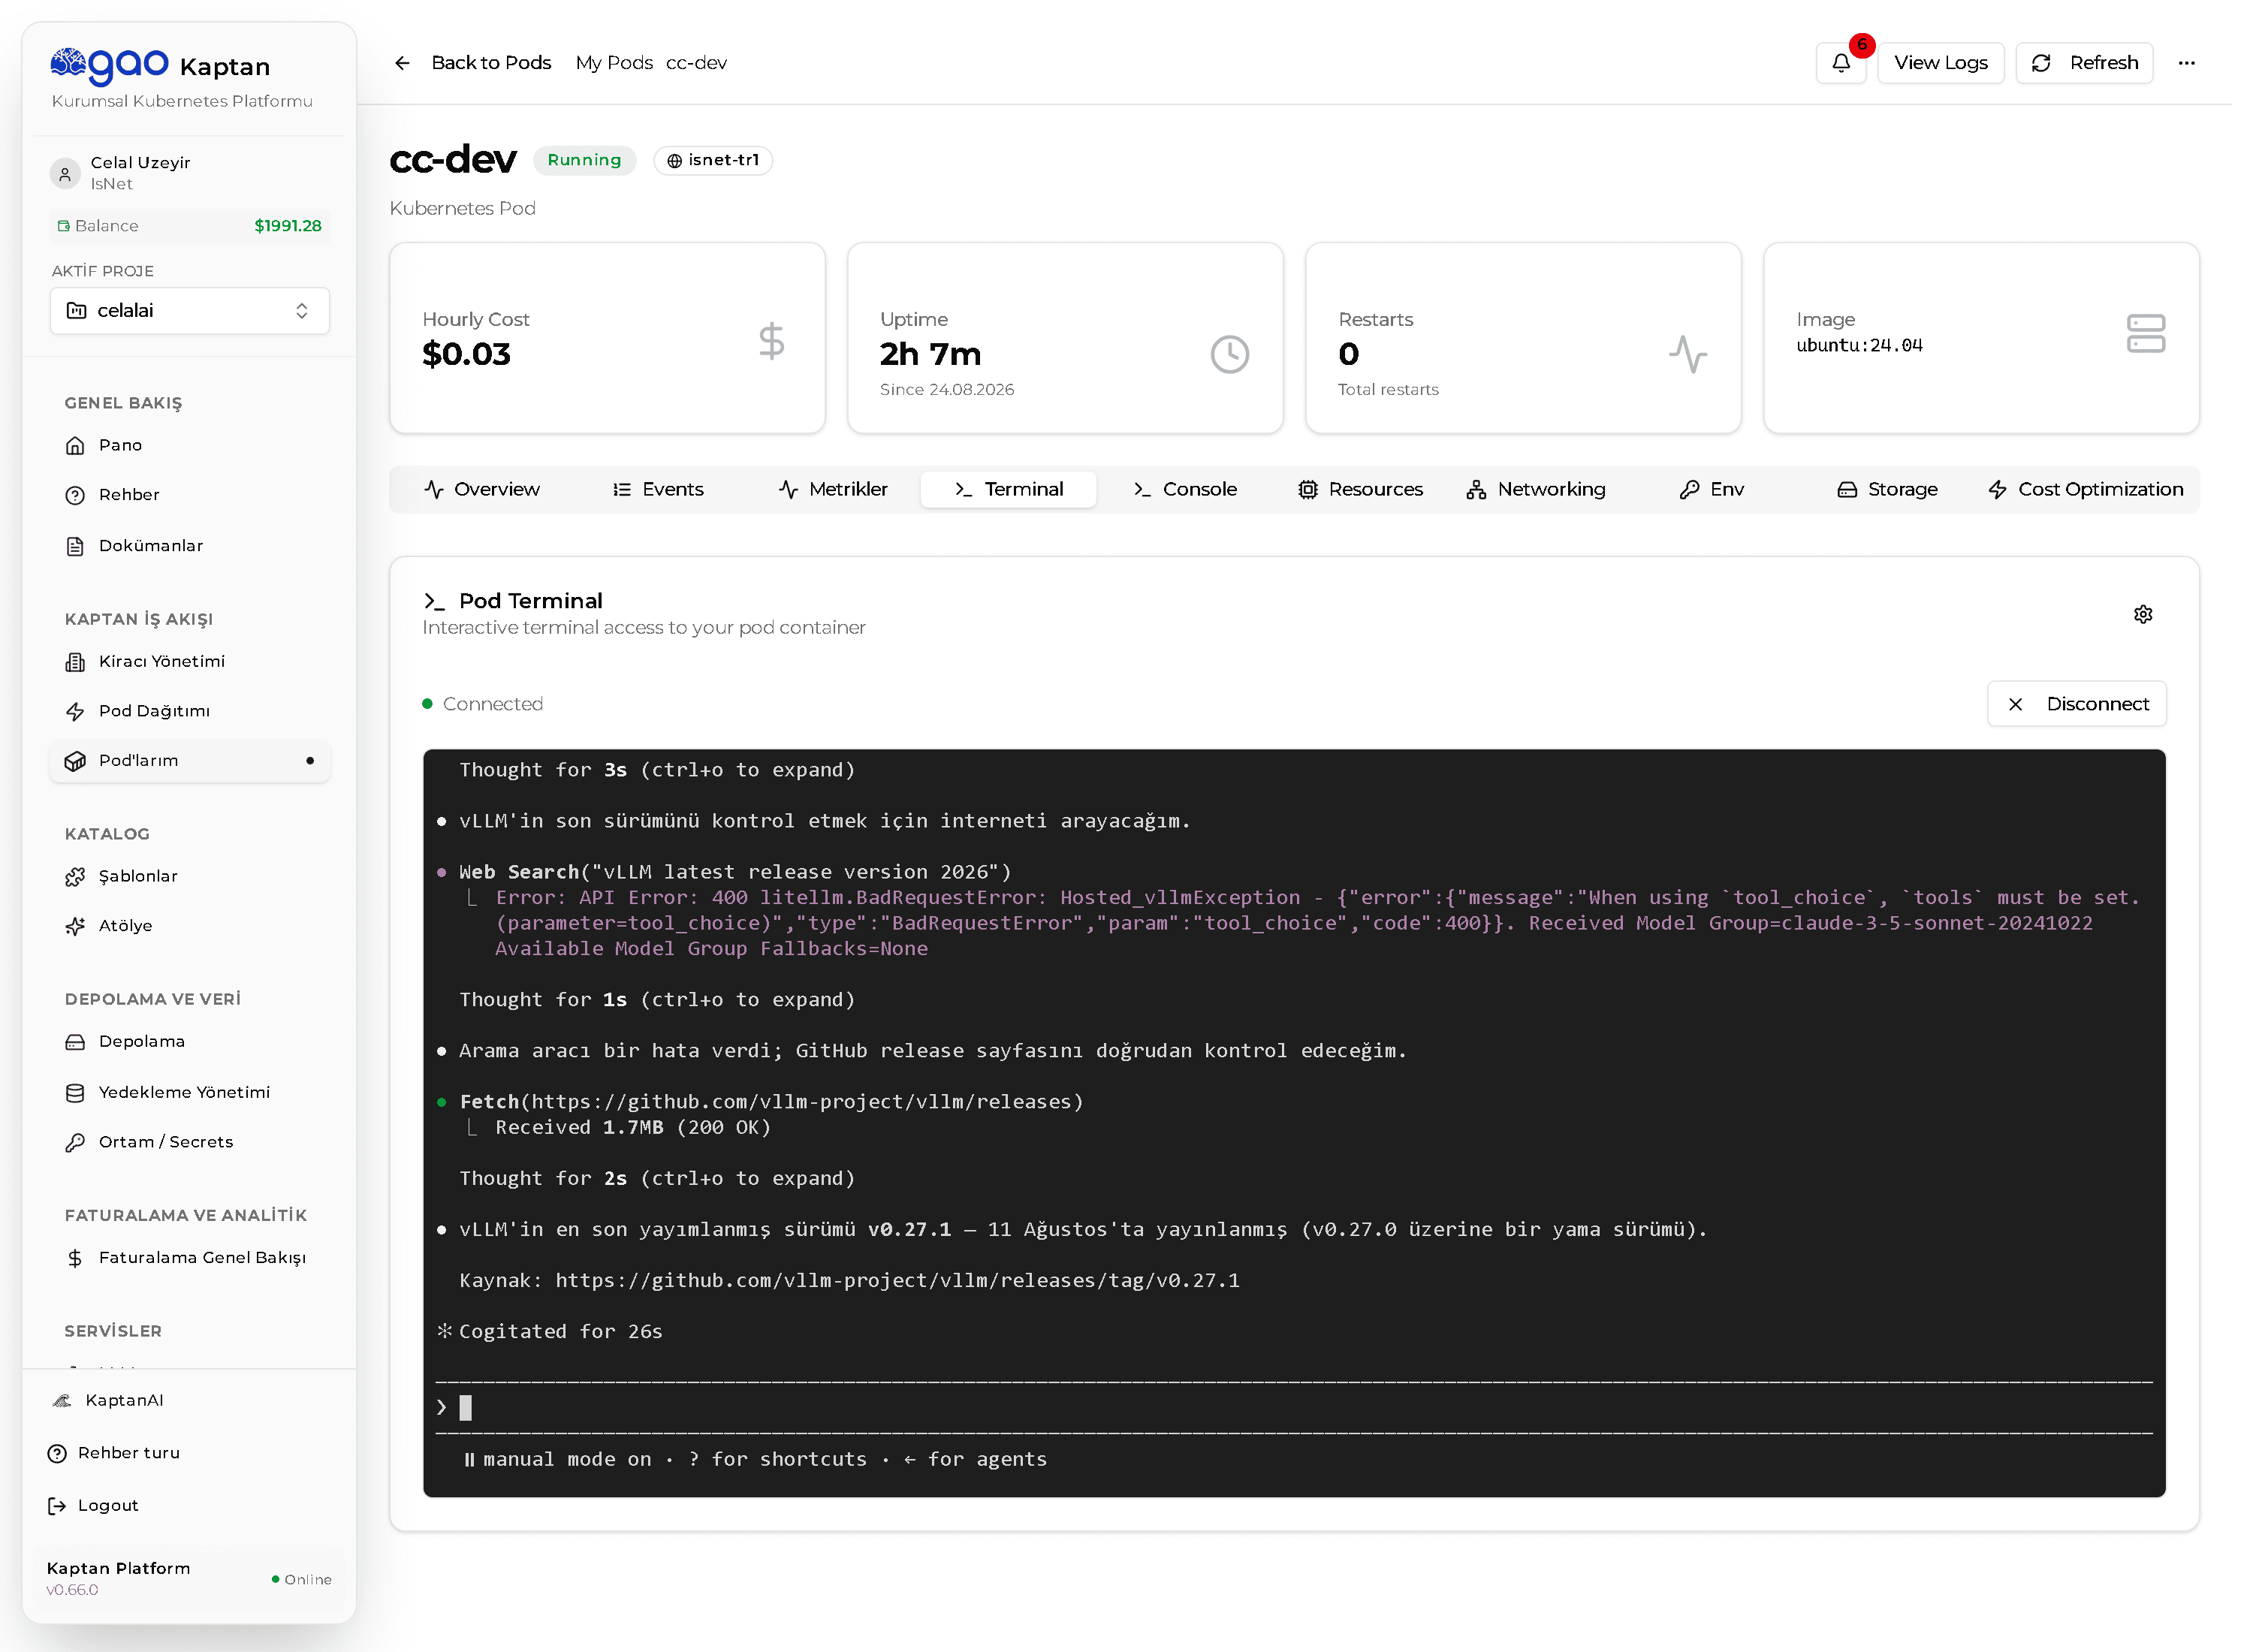
Yukarıdaki koşuda arama hata verdi, ajan GitHub release sayfasını çekti (1,7 MB, 200 OK) ve v0.27.1 cevabını verdi — pod'un içindeki vLLM sürümünün birebir aynısı, yani bilgi gerçekten ağdan geldi.
Aramayı tamamen kapatın
O 400 hatasını hiç görmemenin yolu köprüden geçmiyor. LiteLLM'de "şu aracı düşür" diye bir
ayar yok; drop_params araçlara dokunmaz, tools'u komple düşürürseniz de ajanın bütün
araçları gider. Doğru kaldıraç Claude Code tarafında:
{
  "permissions": {
    "deny": ["WebSearch"]
  }
}
Projenin köküne bu dosyayı koyun, yeterli. Ölçtük: aynı soru bu ayarla tekrar soruldu, çıktıda
tek bir tool_choice hatası yok, ajan doğrudan kaynağa gidip doğru cevabı verdi.
$ claude -p "vLLM in en son surumu hangisi? guncel bilgiyi internetten al"

**vLLM'in en son sürümü: v0.27.1** — 11 Ağustos 2026'da yayınlandı (GitHub releases'a göre).
EXIT=0
Gerçekten arama motoru lazımsa çözüm yine köprü değil, Claude Code'un MCP desteğidir: arama MCP sunucusu istemci tarafında çalışır, isteği köprüye hiç sokmaz. Sağlayıcı anahtarı gerekir.
--dangerously-skip-permissions bunu çözmez. O bayrak yalnızca onay sorusunu atlar, isteğin
gövdesini değiştirmez — hata zaten onaydan sonra, API katmanında oluşuyor. Bayrakla tek
kazancınız aynı 400'ü sorulmadan almak olur.
İnternetsiz (hava boşluğu) kurulum
"Kod dışarı çıkmıyor" demekle "makinenin dışarıyla hattı yok" demek aynı şey değil. İkincisi kanıtlanabilir: geliştirme pod'unu internet erişimi kapalı açın.
Ölçtük — allow_internet_egress: false olan bir pod'dan:
| Hedef | Sonuç |
|---|---|
cc-bridge-svc:4000 (köprü) | ✅ açık |
qwen-cc-svc:8000 (model) | ✅ açık |
| Küme DNS'i | ✅ çözüyor |
github.com:443 | ⛔ kapalı |
registry.npmjs.org:443 | ⛔ kapalı |
1.1.1.1:443 (ham IP) | ⛔ kapalı |
Yani ajan modeline ulaşıyor, internete ulaşamıyor. Ham IP'ye bile çıkamaması önemli: kural DNS seviyesinde değil.
Araç zincirini önceden koyun
npm install -g çalışmaz. Ama gerek de yok — ilginç bir ayrıntı çıktı:
npm paketi bir başlatıcıdır (26 KB). Asıl program optionalDependencies içindeki platform
paketindedir ve tek başına çalışan bir ELF ikilisidir — Node bile gerekmez.
İnternetli bir pod'dan (ya da laptop'unuzdan) tek dosya indirmeniz yeterli:
curl -fsSL -o claude-linux-x64.tgz \
  https://registry.npmjs.org/@anthropic-ai/claude-code-linux-x64/-/claude-code-linux-x64-2.1.241.tgz
Bunu paylaşılan bir kalıcı diske koyun. İnternetsiz pod'da:
mkdir -p /opt/cc && tar xzf /data/offline/claude-linux-x64.tgz -C /opt/cc
chmod +x /opt/cc/package/claude
ln -sf /opt/cc/package/claude /usr/local/bin/claude
claude --version        # 2.1.241 (Claude Code)
Çıplak imajda hiçbir şey yok. ubuntu:24.04 içinde curl, wget, python3 ve xz yok;
internet kapalıyken apt-get de çalışmaz. tar var, bash var, perl var. Node'u da
taşıyacaksanız .tar.xz değil .tar.gz sürümünü indirin — xz olmadığı için açılmaz.
Ağ araçlarını kapatın
İnternet yokken WebFetch'i açık bırakmak ajanı boşuna uğraştırır:
{
  "permissions": {
    "deny": ["WebSearch", "WebFetch"]
  }
}
Telemetri bayrakları gerekli mi?
DISABLE_TELEMETRY, DISABLE_AUTOUPDATER, CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC gibi
bayrakların, dışarı çıkamayan bir ortamda zaman aşımı bekleyerek yavaşlatacağını varsaymıştık.
Ölçtük, öyle değil: aynı görev bayraklı ve bayraksız ikişer kez, iki farklı sırayla
koşturuldu; her iki turda da önce çalışan daha hızlı çıktı (4–7 sn'ye karşı 6–11 sn). Fark
bayraklardan değil, koşu değişkenliğinden geliyor.
Önemli olan şu: hiçbir şey takılmıyor. Bayrakları yine de koyun — dışarı hiç paket çıkmadığından emin olmak için, hız için değil.
Araç yoksa ajan ne yapıyor
Bunu isteyerek denedik: pod'da Python yok, internet yok, ve ajandan dört testi
doğrulaması istendi. Yaptığı şey şu oldu — fib.py'yi düzeltti, sonra testleri imajda bulunan
Perl'e birebir çevirip aynı dört assert'i orada çalıştırdı:
PASS test_zero
PASS test_one
PASS test_five
PASS test_ten_last
4/4 passed
Üstelik yapamadığını da söyledi: "python3'ü kurup test_fib.py'yi doğrudan çalıştıramadım." Test dosyasına dokunmadı. Bu koşu 287 saniye sürdü — internetli ortamdaki benzer iş 43 saniyeydi; aradaki farkın sebebi ağ değil, ajanın çalıştıracak yorumlayıcı araması.
Pratik sonuç: hava boşluğunda çalışacaksanız imaja gerçekten ihtiyaç duyduğunuz araçları
önceden koyun (python3, git, make…). Ajan yokluğu telafi etmeye çalışır, ama bu zaman ve
token harcar.
Ne kazanıyorsunuz, ne kaybediyorsunuz
Kazanç: kod, istem ve dosya içerikleri kümeden çıkmaz. Kullanım başına ücret yok — donanım zaten sizin. Ajanı istediğiniz kadar uzun döngüde çalıştırabilirsiniz.
Kayıp: Qwen3.8-27B iyi bir modeldir ama sınır modeller kadar uzun ve karmaşık görev
taşımaz. Yukarıdaki gibi kapsamı net işler (testi geçir, betik yaz, dosya dönüştür) rahat
gider; çok dosyalı büyük tasarım işlerinde adım sayısı ve hata payı artar. Bağlam da
--max-model-len ile sınırlıdır — 64K, büyük depolarda dar kalabilir.
Pratik kullanım: rutin işi buraya, ağır işi dışarıya.
İlgili sayfalar
- Qwen3.8 27B (FP8, vLLM) — modelin kendisi ve ölçülmüş hızı
- LiteLLM: çok kullanıcılı LLM kapısı — aynı köprüyü ekip için anahtar/bütçe kapısına çevirmek
- GitHub deposuyla çalışmak — ajanın üzerinde çalışacağı kodu pod'a getirmek
LiteLLM: çok kullanıcılı LLM kapısı
İki vLLM kopyasının önüne kullanıcı anahtarı, token tavanı ve bütçe koyun — ölçülmüş maliyetiyle birlikte.
Multica: kendi modelinizle çalışan ajan ekibi
Açık kaynak proje yönetimini Kaptan'a kurun, ajanlarını kendi Qwen'inize bağlayın ve bir işi baştan sona bir ekibe yaptırın.