 Gao Kaptan Docs
Ollama ve MIG
 Ollama ve MIG
MIG üzerinde Ollama çalıştır, model indir ve relay üzerinden modele istek at.
Bu örnek, en basit uçtan uca akışı gerçek ekran görüntüleriyle gösterir: bir MIG GPU dilimi üzerinde Ollama pod'u aç, bir model indir, modelin GPU'da çalıştığını doğrula ve relay üzerinden dışarıdan istek at.
Ollama pod'unu MIG ile oluştur
Pod Dağıtımı (veya Katalog) sayfasından şu ayarlarla bir pod oluşturun:
- İmaj:
ollama/ollama - GPU: MIG profili
1g.18gb - Port:
11434(Ollama API) - Dış erişim (relay): açık
- İnternet erişimi: açık — model indirmek için gerekli
MIG kullanmak için projenizin GPU kotası olan bir tier'da olması gerekir (ör. standard).
Kotanız yoksa "exceeded quota" hatası alırsınız.
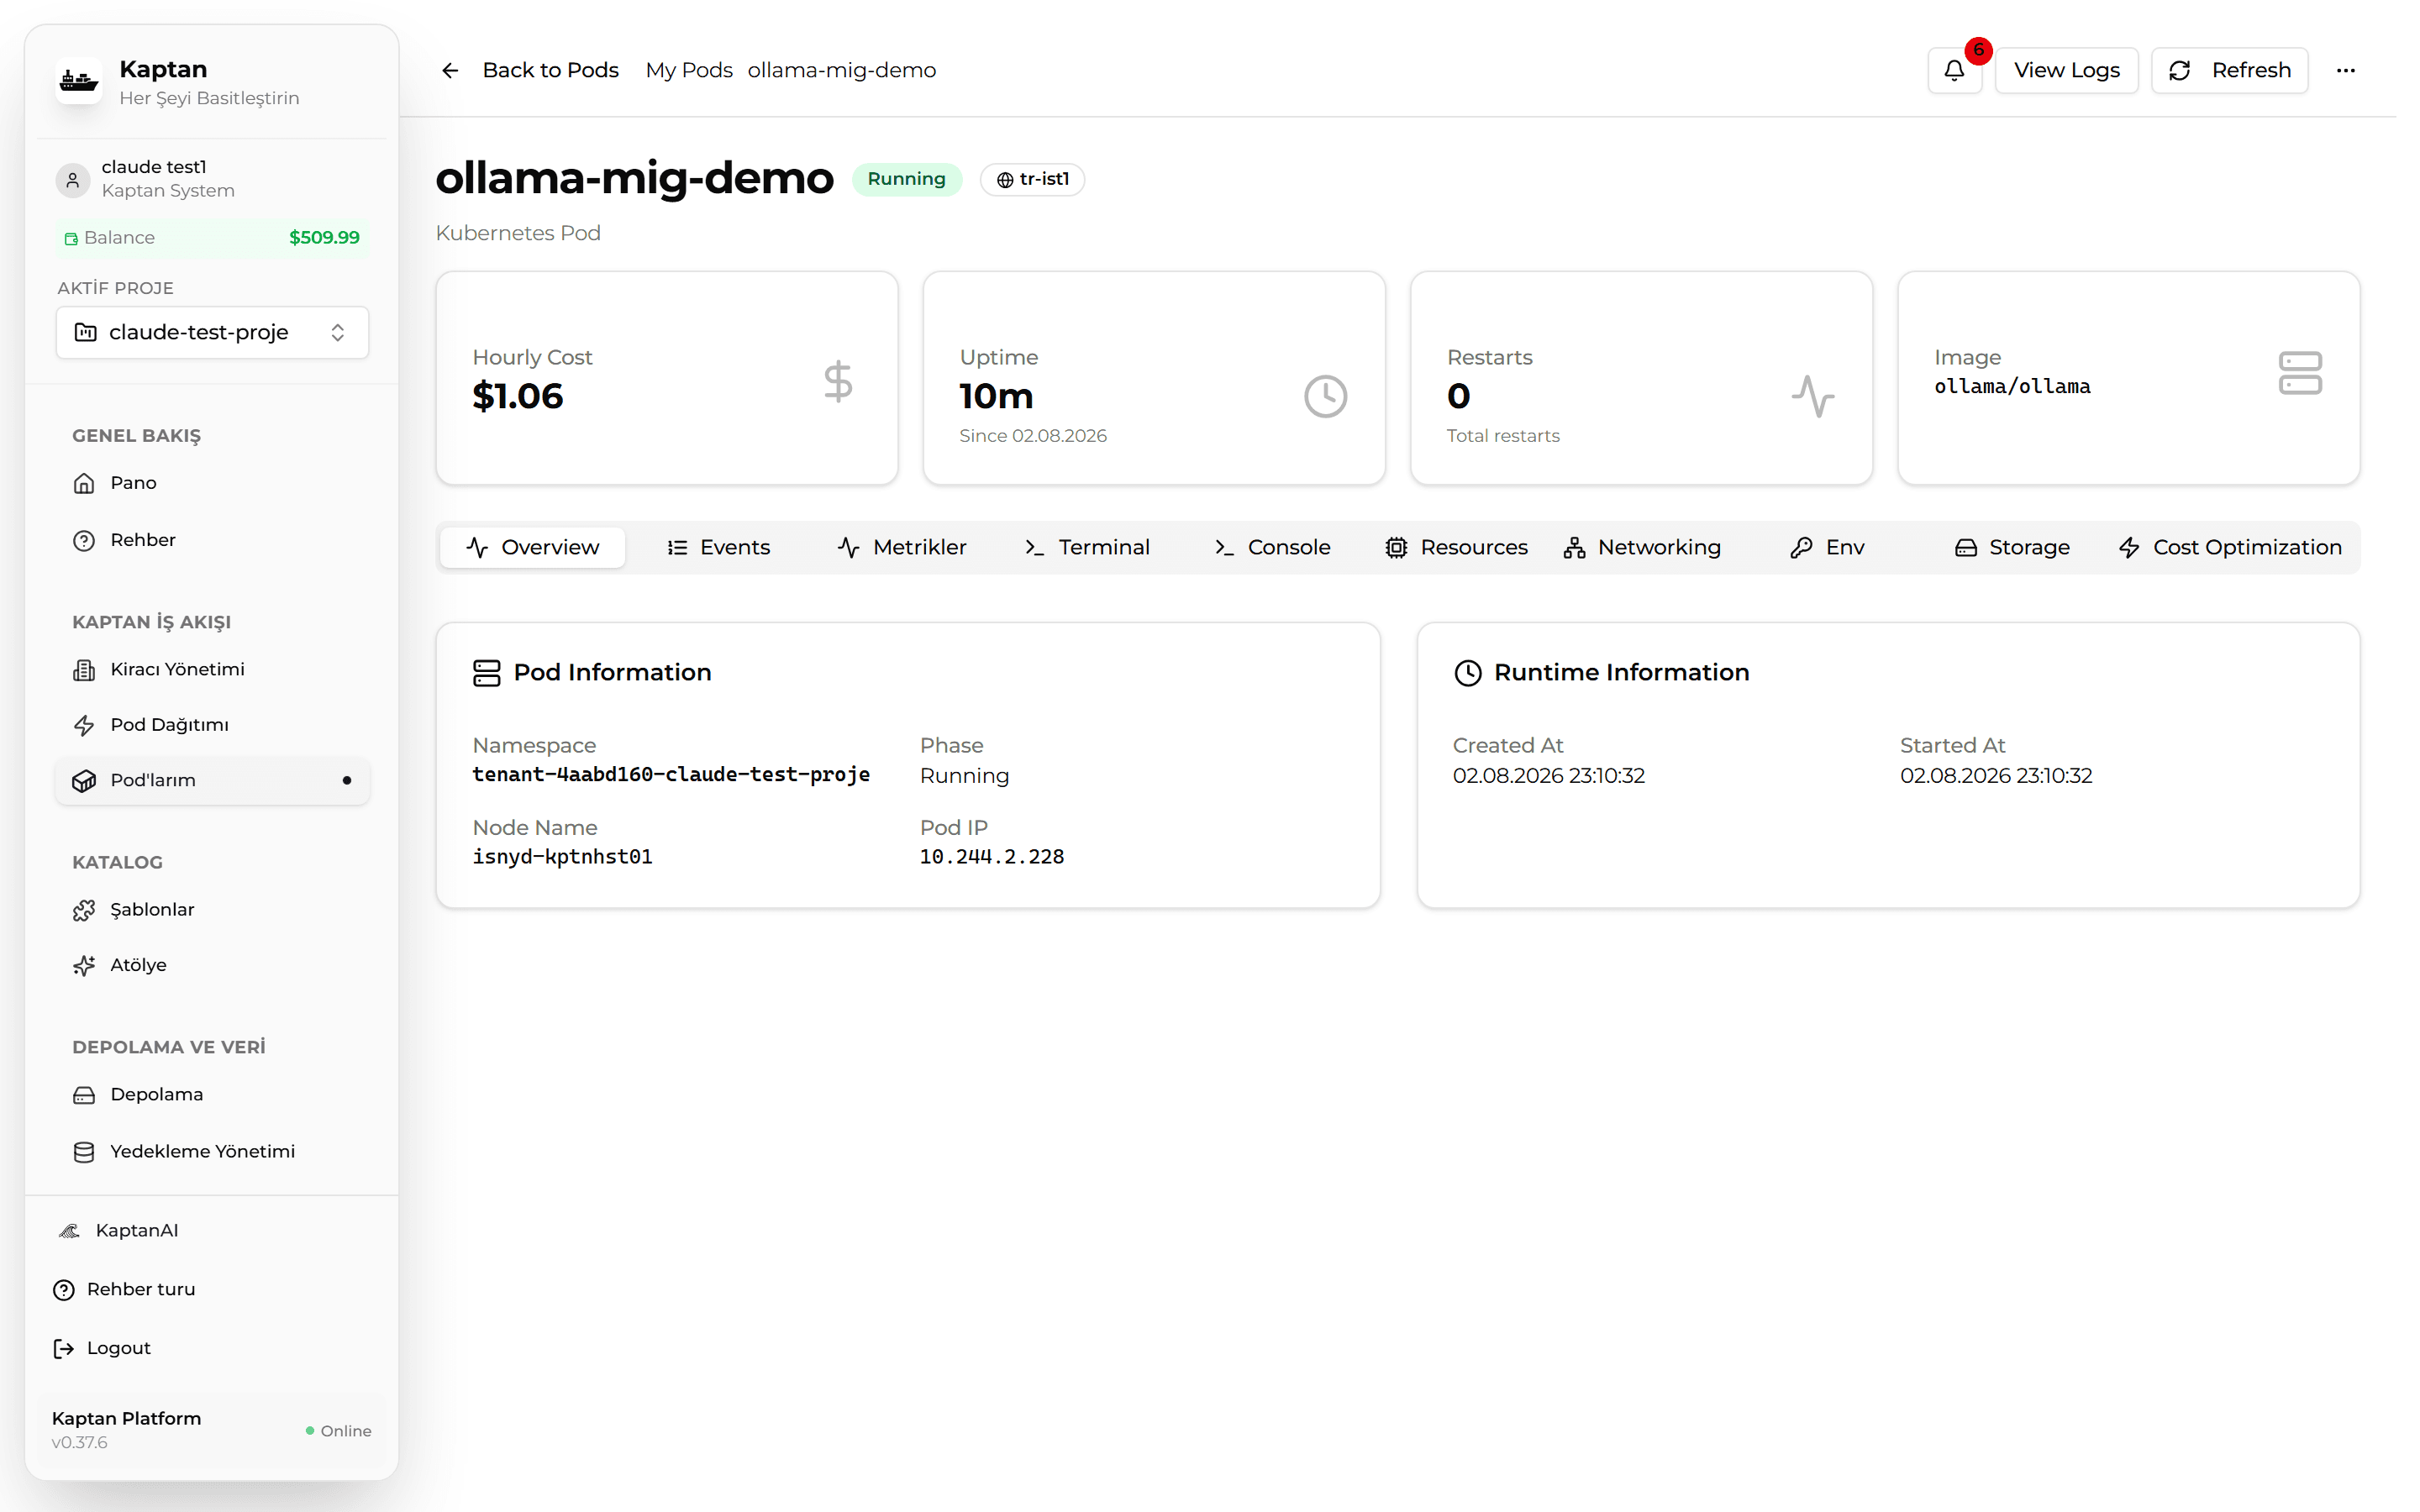
Pod Running olduğunda detay sayfasında imaj, bölge ve saatlik maliyeti görürsünüz — MIG
1g.18gb bu örnekte toplam ~$1.06/sa (MIG dilimi + CPU/bellek).
Modeli indir
Pod detayındaki Terminal sekmesinden bağlanıp küçük bir model çekin:
ollama pull qwen2:0.5b
ollama list
GPU'da çalıştığını doğrula
Modeli bir kez çalıştırıp ollama ps ile PROCESSOR sütununa bakın — 100% GPU olmalı.
nvidia-smi -L de dilimin H200 NVL / MIG 1g.18gb olduğunu gösterir:
ollama ps
# NAME         ID            SIZE    PROCESSOR   CONTEXT   UNTIL
# qwen2:0.5b   6f48b936a09f  436 MB  100% GPU    4096      27 minutes from now

nvidia-smi -L
# GPU 0: NVIDIA H200 NVL (UUID: GPU-...)
#   MIG 1g.18gb  Device 0: (UUID: MIG-...)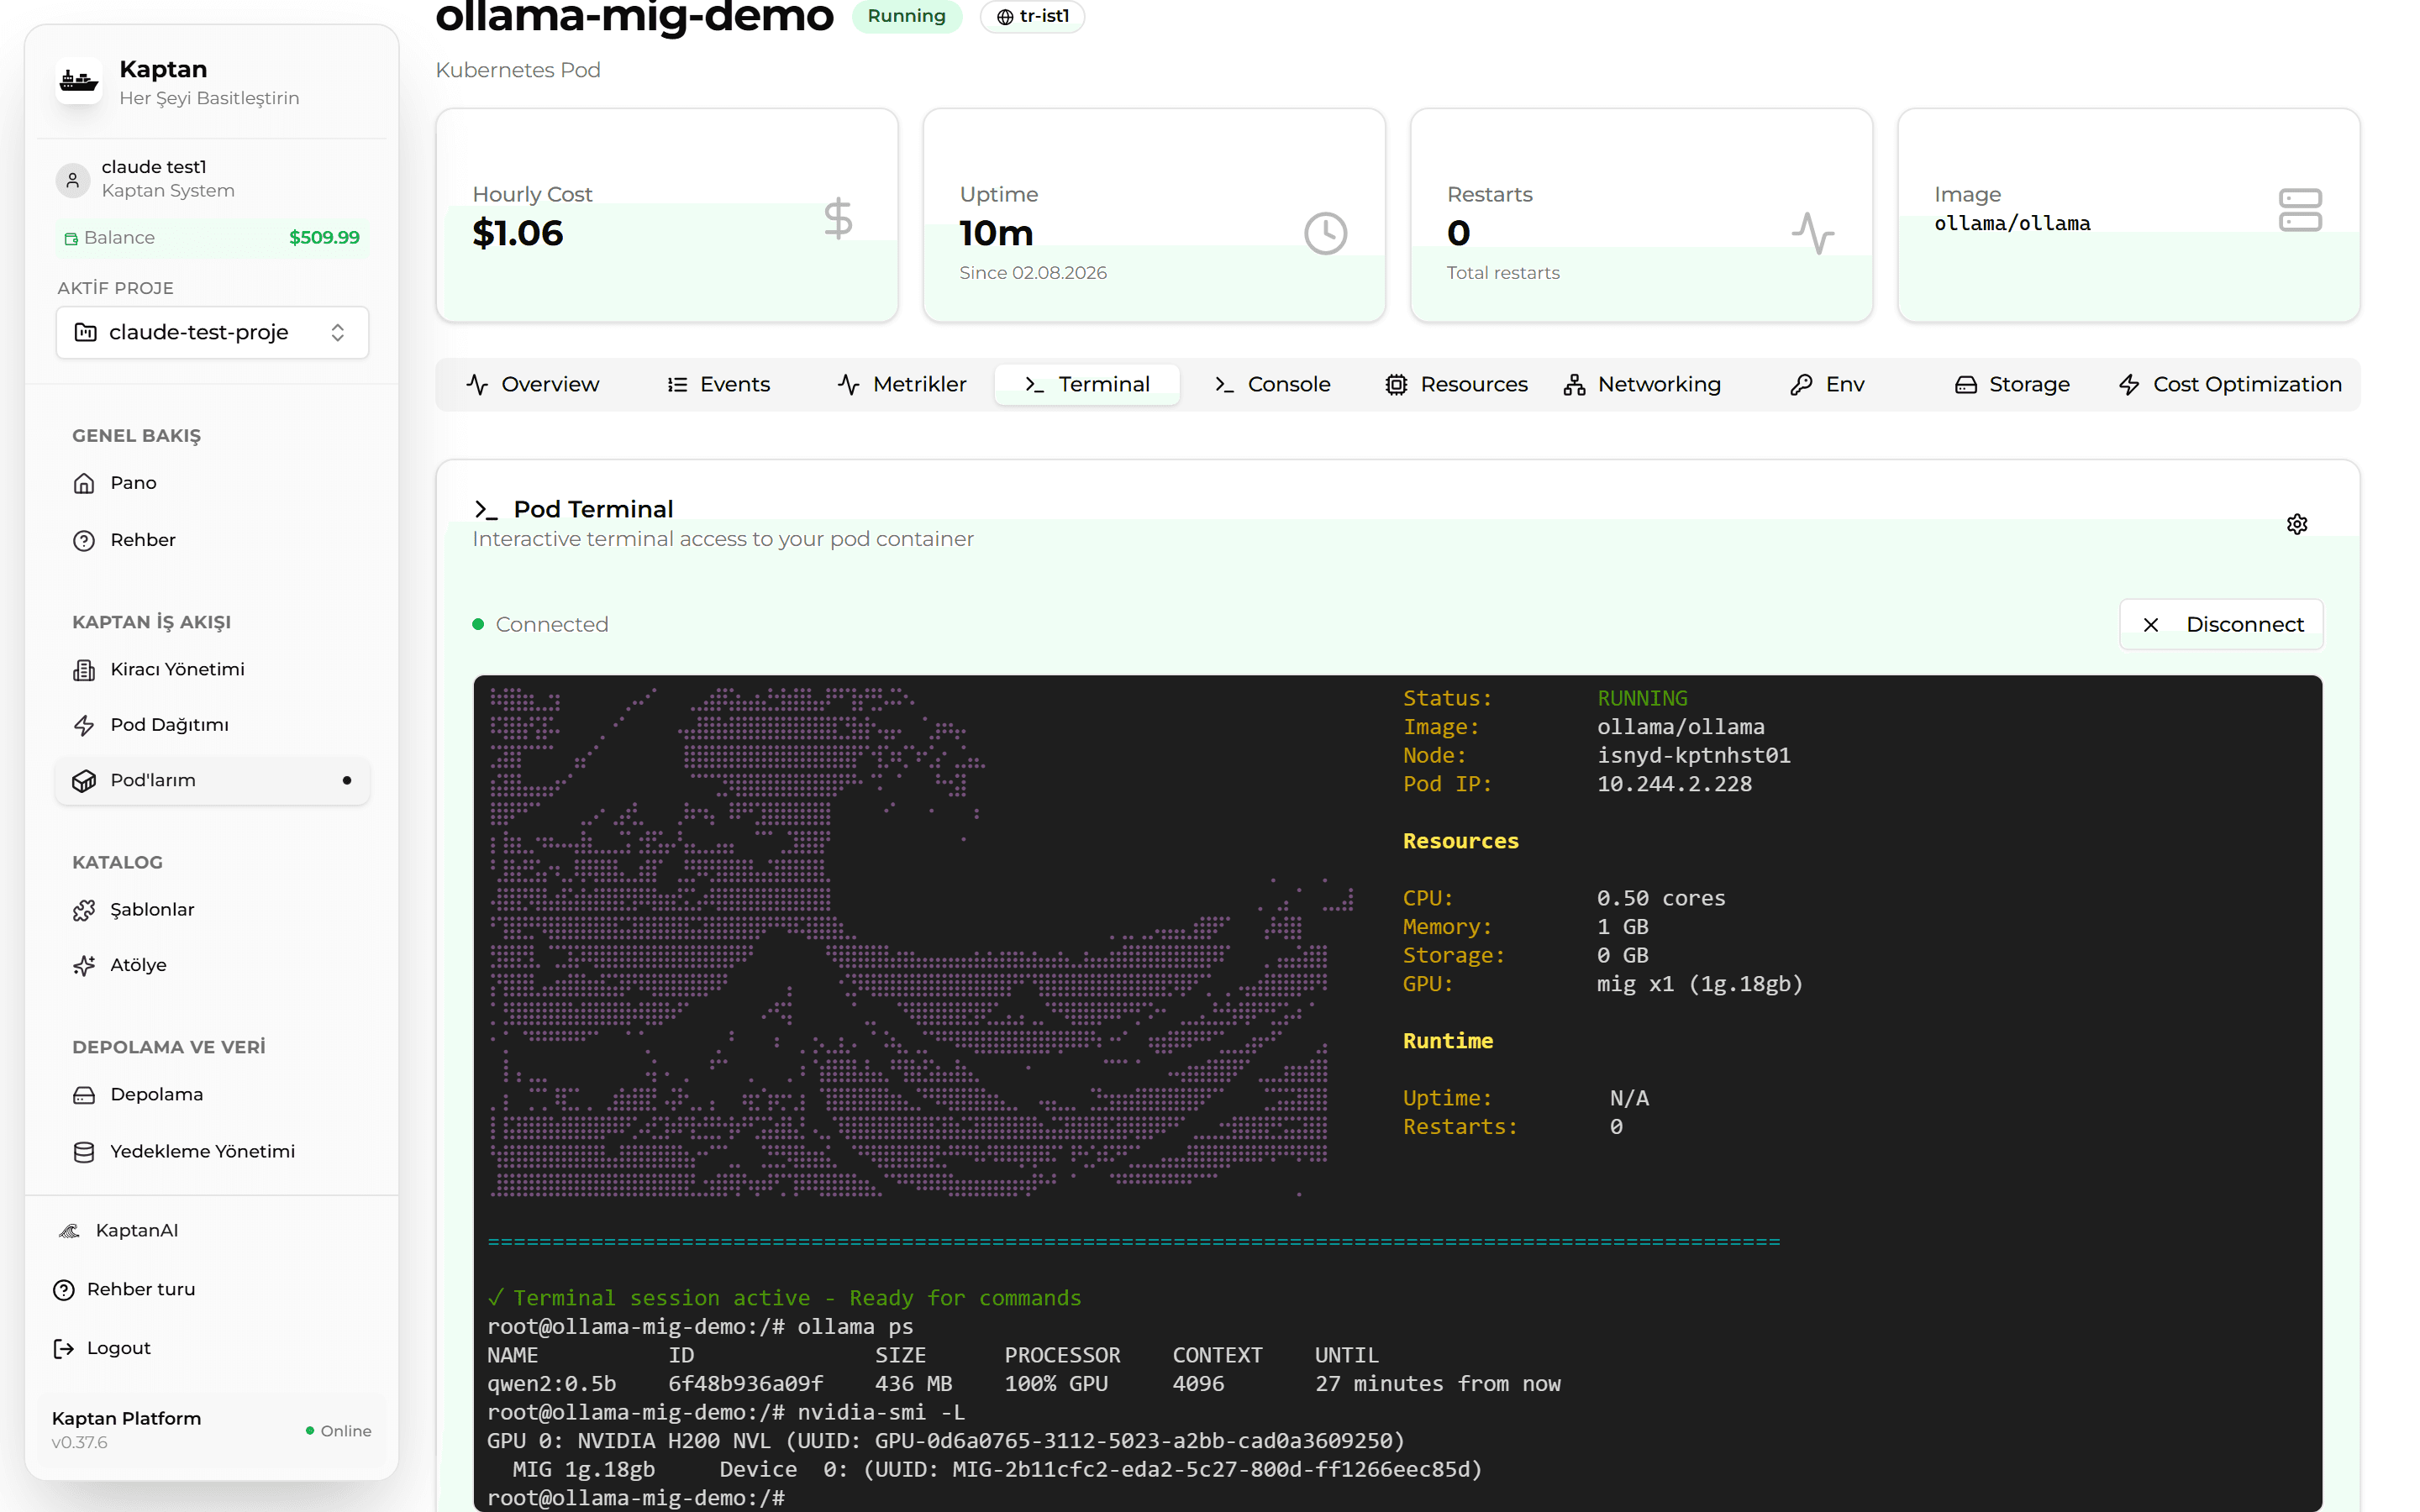
Relay üzerinden modele istek at
Pod'un erişim token'ını alın, sonra kptnpods.isnet.net.tr relay'i üzerinden Ollama API'sine
istek atın:
# 1) Erişim token'ı (bir kez)
curl -s -X POST https://kaptan.isnet.net.tr/api/v1/pods/<POD_ID>/access-token/regenerate \
  -H "Authorization: Bearer <JWT>"
# -> { "data": { "api_token": "<API_TOKEN>" } }

# 2) Relay üzerinden /api/generate
curl -s -X POST \
  "https://kptnpods.isnet.net.tr/api/generate?kaptan_subdomain=<subdomain>&kaptan_token=<API_TOKEN>" \
  -H "Content-Type: application/json" \
  -d '{"model":"qwen2:0.5b","prompt":"Merhaba, kısaca kendini tanıt","stream":false}'
Yanıt (HTTP 200):
{
  "model": "qwen2:0.5b",
  "response": "...model çıktısı...",
  "done": true,
  "total_duration": 256244314,
  "eval_count": 22
}
<subdomain> pod'un ingress host'unun ilk etiketidir (ör. ollama-mig-demo-9201051e). Relay
port'tan bağımsızdır; aynı yöntemle vLLM (:8000) gibi başka servislere de erişebilirsiniz.
Özet
Tek bir MIG dilimi (1g.18gb) üzerinde Ollama'yı çalıştırdınız, bir model indirdiniz, GPU'da
koştuğunu doğruladınız ve relay üzerinden dışarıdan istek attınız. Aynı akış daha büyük MIG
profilleri (2g.35gb, 3g.71gb) veya tam GPU için de geçerlidir — sadece maliyet
profile göre değişir.